Operator telekomunikasi · melalui Accenture · 2026–present
Agen Suara AI Real-Time yang Di-host Mandiri
AI Engineer
Proyek klien. Nama, data, dan detail identitas dirahasiakan; arsitektur dijelaskan secara umum.
Masalah
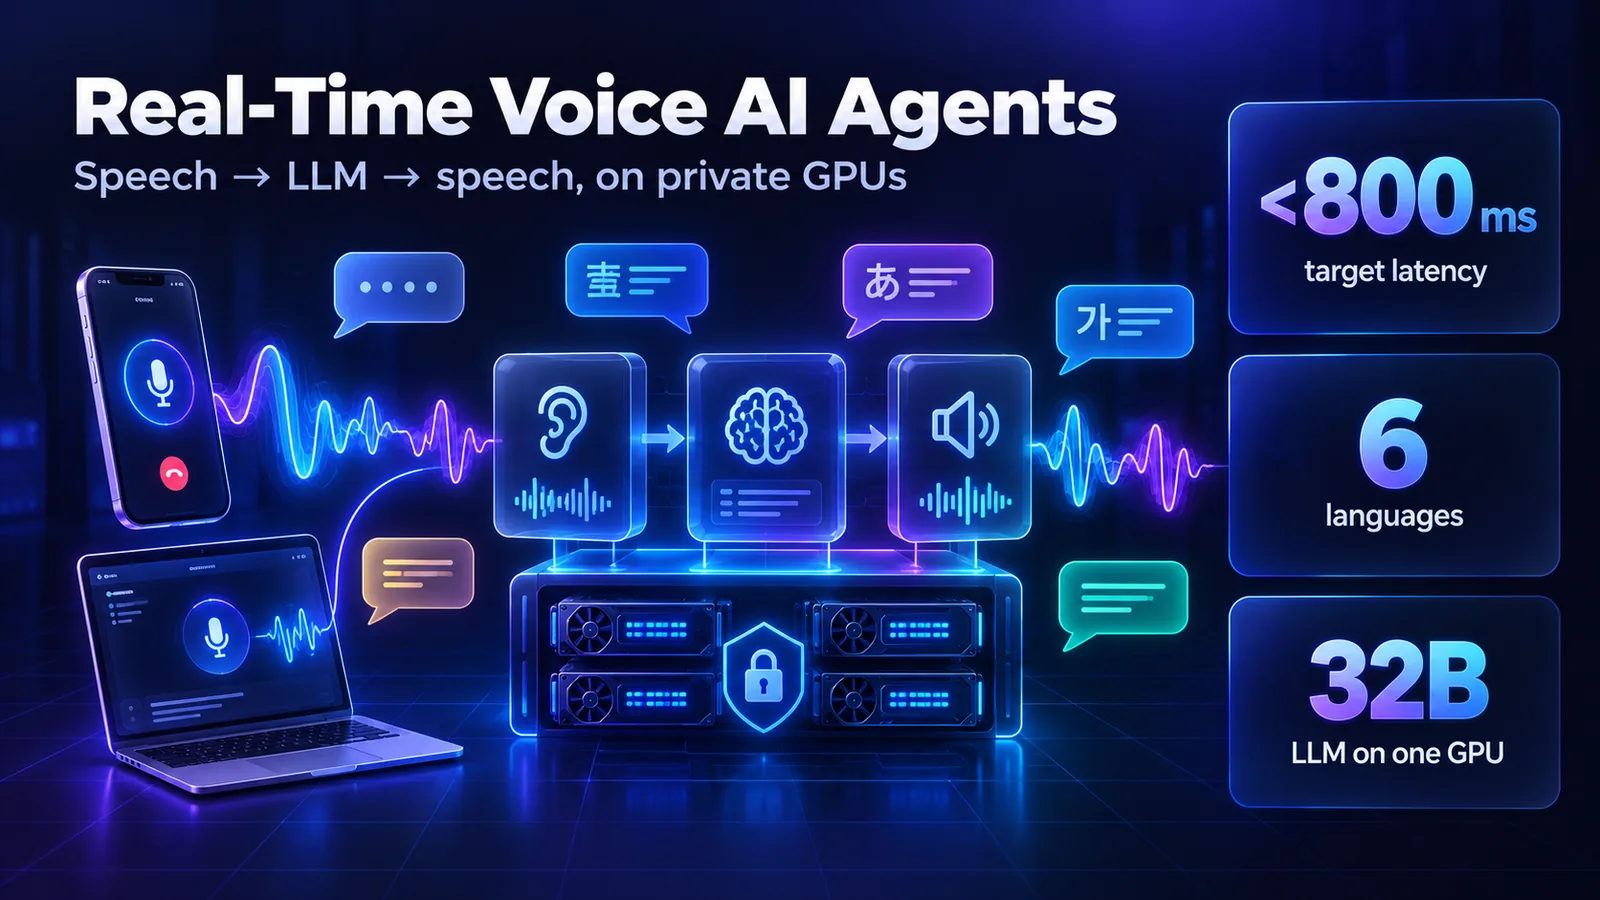
Operator menginginkan agen suara AI untuk layanan pelanggan dan IVR, tetapi rekaman, transkrip, dan prompt harus tetap di infrastruktur privat. Penelepon juga mengharapkan percakapan yang alami: balasan cepat, bisa menyela, dan berganti bahasa di tengah panggilan.
Pendekatan
Saya sedang membangun pipeline Pipecat berbasis streaming di mana setiap model berjalan sebagai layanan GPU tersendiri di balik API yang kompatibel dengan OpenAI, sehingga penyedia model bisa diganti per agen. Operator mengonfigurasi agen sekali (persona, suara hasil kloning, dokumen pengetahuan, guardrail, bahasa) dan setiap panggilan membangun pipeline baru dari konfigurasi itu. Secara paralel saya menjadikannya akselerator multi-tenant yang dapat dipakai ulang dengan UI manajemen, serta mengevaluasi kloning suara dan avatar lip-sync untuk aset AI Accenture yang dapat dipakai ulang.
Arsitektur
Arahkan kursor ke komponen untuk melihat koneksinya · geser untuk menggeser · gunakan + / − untuk zoom
- Sumber
- Pemrosesan
- Model
- Agen / optimizer
- Penyimpanan data
- Output
Cara Kerja
- TerhubungWeb dan aplikasi mobile lewat WebRTC atau WebSocket, ditambah proof of concept telepon: panggilan yang dijembatani Asterisk SIP dengan serializer audio khusus (G.711, Opus, AMR-WB), serta panggilan WhatsApp.
- MendengarReduksi noise dan Silero VAD mendeteksi suara; model deteksi giliran bicara menentukan kapan penelepon selesai berbicara.
- TranskripsiWhisper yang dikompilasi dengan TensorRT-LLM, dibatasi pada bahasa panggilan, dengan langkah pembersihan output halusinasi.
- BerpikirQwen3-32B (AWQ) di vLLM mengalirkan balasan. Tool dapat mengakhiri panggilan atau berganti bahasa, dan tahap kedua menegakkan guardrail serta menghapus format yang tidak perlu diucapkan.
- BerbicaraSuara GPT-SoVITS yang di-fine-tune untuk bahasa Indonesia, dengan frontend fonem (G2P) khusus, mengalirkan audio kembali; suara dapat dikloning dari audio referensi, dan setiap bahasa memiliki cabang TTS sendiri.
- Rekam & tinjauPenelepon dapat menyela kapan saja (barge-in). Transkrip dan rekaman disimpan untuk dashboard operator.
Yang Saya Bangun
- Layanan orchestrator dan pipeline Pipecat per panggilan, termasuk pemanggilan tool dan pergantian bahasa di tengah panggilan.
- Layanan model: STT Whisper di TensorRT-LLM, Qwen3-32B (AWQ) di vLLM, dan TTS GPT-SoVITS hasil fine-tuning bahasa Indonesia dengan frontend fonem G2P khusus.
- Proof of concept telepon: jembatan SIP/RTP Asterisk dengan penanganan codec untuk audio telepon, serta panggilan WhatsApp.
- Layanan GPU di AWS ECS dengan Terraform: autoscaling berbasis metrik GPU, pemantauan CloudWatch, dan penyimpanan model bersama.
- Akselerator yang dapat dipakai ulang: UI manajemen React (agen, suara, pengetahuan, guardrail, percakapan, playground model) dengan penyedia cloud atau self-hosted yang bisa diganti.
- Load test Locust yang mengukur latensi dan throughput STT, LLM, dan TTS.
Dampak
Masih berjalan. Agen suara ini sudah berjalan end-to-end di GPU privat melalui kanal web dan aplikasi, dengan panggilan telepon dan WhatsApp yang sudah dibuktikan lewat proof of concept, dan komponennya menjadi bagian aset AI Accenture yang dapat dipakai ulang. Saya menulis hampir seluruh kode untuk deployment klien.