Gambar yang Tidak Bisa Ditanya
Tanyakan ke seorang process engineer katup mana saja yang ada di antara sebuah pompa dan sebuah tangki. Di banyak pabrik, jawabannya dimulai dengan membuka PDF lalu menelusuri garis dengan jari. P&ID (piping and instrumentation diagram) menyimpan pengetahuan itu: setiap vessel, katup, instrumen dan pipa, serta apa terhubung ke apa. Tapi di pabrik yang lebih tua, P&ID sering hanya ada sebagai gambar, jadi komputer cuma bisa menampilkannya, tidak lebih.
Yang kita butuhkan adalah gambar yang sama dalam bentuk data: komponen di satu tabel, koneksi di tabel lain, atau sebuah graf tempat pertanyaan "apa yang ada di hulu katup ini" cukup dijawab dengan satu query. Saya membuat pid-parser untuk melakukan konversi itu dengan vision LLM, lalu mengukurnya terhadap ground truth sampai hasilnya cukup layak untuk dibagikan.
Kode: github.com/dzakybd/pid-parser (MIT) · Demo: huggingface.co/spaces/dzakybd/pid-parser
TL;DR
- Apa itu: sebuah skill agen. Beri gambar P&ID, dapatkan
graph.jsonplus SQL, CSV, GraphML dan Cypher untuk Neo4j. Pasang dengannpx skills add dzakybd/pid-parser.- Caranya: tanpa GPU dan tanpa training. Vision LLM membaca gambar dalam dua tahap, simbol dulu lalu pipa; skrip kecil memotong gambar, memeriksa graf dan mengekspornya.
- Seberapa bagus: dengan gpt-6.1-sol, F1 koneksi 0,80 pada lembar nyata dari dataset PID2Graph dan 0,83 pada lembar sintetis, tiga sampai enam menit per lembar.
- Kenapa berhasil: pipa melintasi seluruh lembar, jadi tahap pipa selalu melihat seluruh lembar.
Cara Kerjanya, Langkah demi Langkah
Gambar-gambar di bawah mengikuti satu lembar sintetis dari PID2Graph melewati pipeline. Pada lembar ini gpt-6.1-sol mendapat skor 1,00 untuk simbol maupun koneksi.
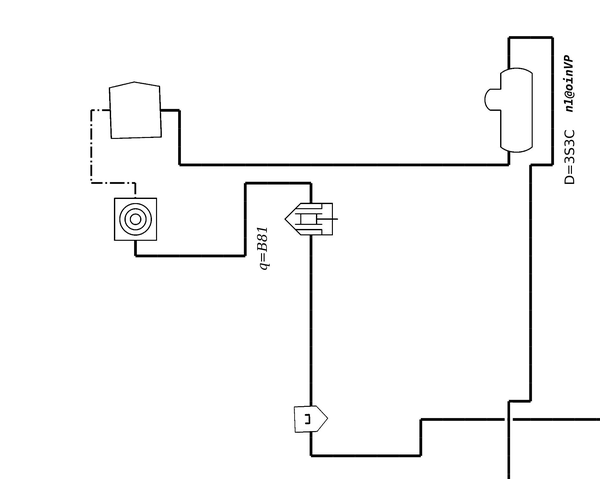
1. Gambarnya. Inputnya satu lembar P&ID dalam bentuk gambar, hasil scan atau ekspor. Ini sebagian dari lembarnya.
2. Potong. Skrip memotong lembar menjadi potongan berukuran 1200 piksel yang saling tumpang tindih, lalu menggambar grid piksel di atasnya. Potongan-potongan itu tumpang tindih ke samping maupun ke bawah. Setiap tetangga berbagi minimal 150 piksel, dan karena skrip menyebar potongan secara merata di seluruh lembar, overlap sebenarnya biasanya jauh lebih besar: pada lembar di bawah, 780 piksel ke samping dan 1250 piksel ke bawah, dalam piksel asli. Idenya sama dengan chunking dokumen panjang dengan overlap sebelum dimasukkan ke model. Vision model memperkecil gambar besar sebelum membacanya, jadi di lembar utuh sebuah katup yang lebarnya hanya beberapa puluh piksel berubah jadi noda; di dalam potongan, katup itu tetap terbaca. Overlap-nya ada untuk alasan yang sama dengan overlap pada chunk: simbol yang terbelah oleh tepi satu potongan tetap utuh di potongan berikutnya. Harganya, simbol di bagian tengah lembar bisa muncul di sampai empat potongan, dan kode harus menggabungkan salinan-salinan itu kembali menjadi satu.
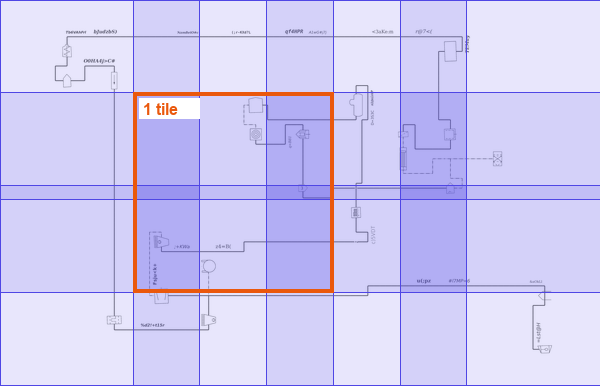
Apakah model sekuat gpt-6.1-sol masih butuh potongan? Saya mengukur tahap simbol saja dengan dua cara pada keenam lembar, dinilai terhadap ground truth:
| Lembar | Seluruh lembar, 1 panggilan: F1 simbol | Potongan: panggilan, F1 simbol |
|---|---|---|
| Nyata, padat (102 simbol) | 0,97 | 6 panggilan, 0,91 |
| Nyata (41 simbol) | 0,95 | 6 panggilan, 0,91 |
| Nyata (101 simbol) | 0,96 | 6 panggilan, 0,91 |
| Sintetis 1 | 0,98 | 12 panggilan, 0,88 |
| Sintetis 2 | 1,00 | 12 panggilan, 1,00 |
| Sintetis 3 | 1,00 | 12 panggilan, 0,98 |
Kalau berdiri sendiri, seluruh lembar menang. Kedua cara menemukan simbol yang sama; potongan kalah di presisi, karena area yang tumpang tindih menghasilkan duplikat yang tidak selalu tertangkap saat digabung. Jadi saya menjalankan pipeline lengkap dengan tahap simbol pada seluruh lembar. Hasil akhirnya tidak lebih baik: F1 koneksi 0,61 lawan 0,75 di satu lembar nyata dan 0,85 lawan 0,84 di lembar yang padat. Agen pipa tetap merevisi daftar simbol, dan keunggulan di awal itu hilang: agen menambah sepuluh simbol di satu lembar dan membuang tiga belas di lembar lain. Potongan tetap jadi default karena tiga alasan lain. Tahap pipa memperbesar tampilan lewat potongan yang sudah ditandai. Lembar berukuran 7000 kali 4500 terlalu besar untuk diterima API sebagai satu gambar ("exceeding the limit of 30000 patches"). Dan dengan model yang lebih kecil, gpt-6-luna, potongan adalah pembeda antara menemukan sepertiga simbol dan menemukan sebagian besarnya (F1 simbol 0,33 lawan 0,81).
3. Simbol, satu panggilan per potongan. Untuk setiap potongan, model mencatat semua simbol yang terlihat: tipenya (katup, pompa, vessel, instrumen dan seterusnya), tag yang tercetak di dekatnya, dan kotak posisinya. Kotak dikembalikan relatif terhadap potongan lalu dikonversi oleh kode ke piksel asli, karena model bisa melaporkan posisi dalam salinan gambarnya sendiri yang sudah diperkecil, bukan gambar aslinya. Setelah itu kode menggabungkan duplikat dari area yang tumpang tindih.
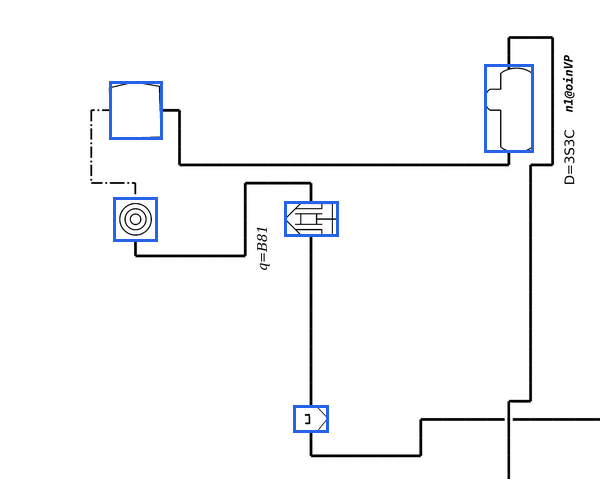
4. Gambar id-nya. Skrip menuliskan id setiap simbol di atas gambar. Sekarang model bisa bilang "s10 terhubung ke s11" alih-alih menjelaskan letaknya, yang jauh lebih sering salah.
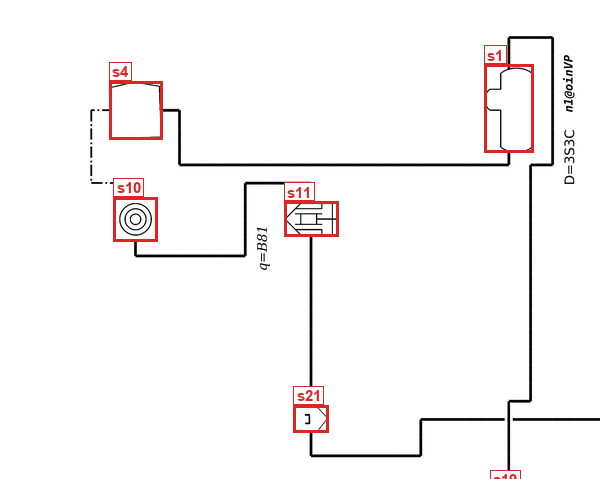
5. Pipa, pada seluruh lembar. Agen membuka gambar keseluruhan dan potongan yang sudah ditandai, lalu menelusuri setiap garis dari id ke id. Katup di tengah garis memecahnya menjadi dua edge. Di titik tempat tiga pipa atau lebih bertemu, agen menambahkan node junction. Garis instrumen putus-putus menjadi edge signal.
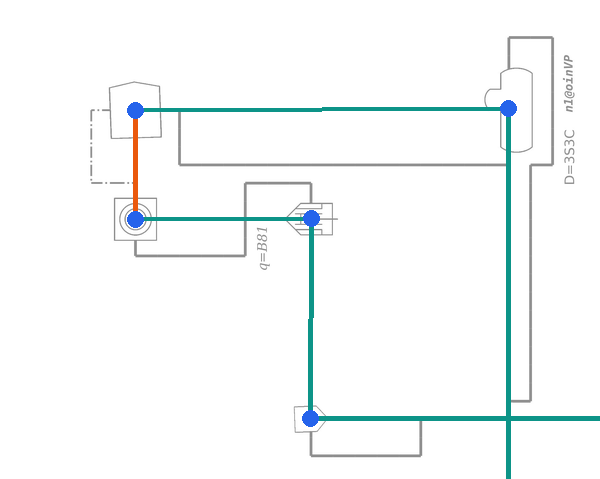
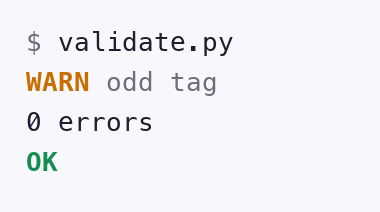
6. Validasi. Skrip memeriksa graf dengan aturan sederhana: id yang tidak dikenal, edge yang tidak tersambung, katup yang terisolasi, junction dengan kurang dari tiga cabang, dan tag yang tidak terlihat seperti tag. Skrip ini tidak punya kunci jawaban dan tidak memakai model; ia hanya menangkap hal yang tidak mungkin benar di P&ID mana pun. Agen kembali ke setiap titik yang ditandai dan memperbaiki yang salah. Di sini satu-satunya peringatan adalah soal tag, karena lembar sintetis memakai string acak sebagai tag.
7. Ekspor. Graf dikeluarkan sebagai SQL, CSV, GraphML dan Cypher.
| File | Cara memuat |
|---|---|
pid.sql | sqlite3 pid.db < pid.sql atau psql -f pid.sql |
nodes.csv, edges.csv | spreadsheet apa saja atau COPY |
graph.graphml | NetworkX, Gephi, yEd |
graph.cypher | cypher-shell -f graph.cypher (Neo4j) |
Apa yang Bisa Ditanyakan
Kedua format menjawab pertanyaan yang berbeda. SQL untuk menghitung dan memfilter: berapa jumlah tiap komponen, katup mana yang tidak punya tag, line mana yang membawa nomor line tertentu. Ini empat tipe komponen yang paling banyak di lembar di atas:
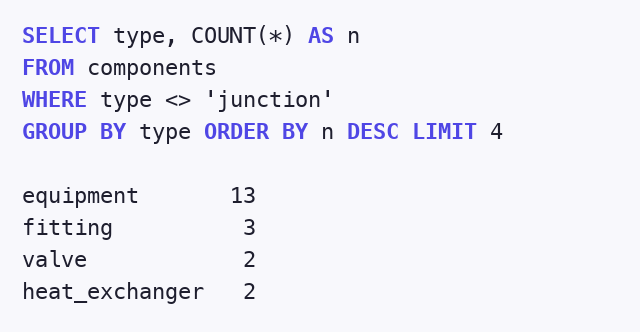
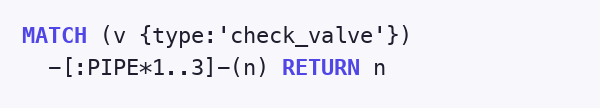
Graf untuk pertanyaan "apa terhubung ke apa". Pipa bertemu di junction sebelum sampai ke peralatan, jadi di SQL tetangga langsung sebuah katup sering kali hanya titik junction, dan menelusuri pipa butuh satu self-join per langkah. Di Neo4j, satu pola query bisa berjalan melewati semuanya. Query ini menanyakan apa saja yang dijangkau check valve dalam tiga langkah pipa:
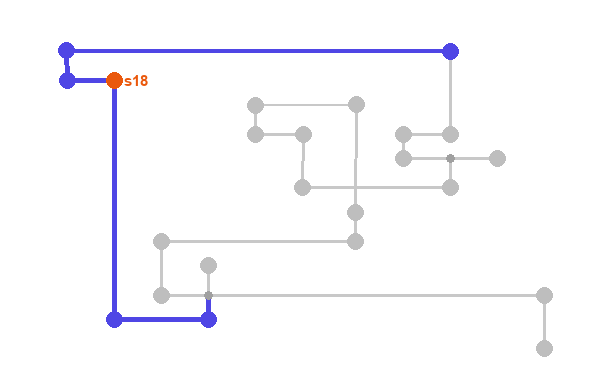
Saya memuat hasil ekspor ke SQLite dan ke container Neo4j 5 untuk memastikan keduanya jalan, dan Space showcase berisi tiga lembar yang sudah dikonversi lengkap dengan semua file unduhannya.
Dua Cara Menjalankannya: Skill atau Deep Agent
Semuanya ada dalam satu repository, dzakybd/pid-parser (MIT), dengan demo di Space Hugging Face:
pid-parser/
├── skills/pid-parser/   skill-nya: SKILL.md + tile.py, mark.py, validate.py, export.py
├── agent/run.py         versi LangChain Deep Agents, yang menjalankan skill yang sama
├── eval/                penilai berbasis ground truth dan skrip perbandingan
└── space/               showcase Hugging Face
Folder skill adalah satu-satunya sumber. Versi Deep Agents tidak menyalin instruksinya; ia memuat SKILL.md yang sama, jadi perbaikan pada skill langsung berlaku untuk keduanya.
Sebagai skill di Claude Code, Codex atau harness lain
npx skills add dzakybd/pid-parserLalu minta: "Use the pid-parser skill to parse drawing.png." Agen membaca SKILL.md dan menjalankan skripnya. Skripnya hanya butuh Python dan Pillow. Ini jalur termudah kalau Anda sudah memakai salah satu tool tersebut.
Sebagai LangChain Deep Agent, dengan login ChatGPT
Untuk pipeline yang dijalankan dari kode sendiri, agent/run.py membangun alur yang sama dengan LangChain Deep Agents. Ia berjalan dengan langganan ChatGPT lewat provider login dengan ChatGPT, jadi tidak perlu API key OpenAI.
| Komponen | Versi |
|---|---|
| Python | 3.12 |
deepagents | 0.7.25 |
langchain-openai | 1.7.2 (untuk _ChatOpenAICodex, masih eksperimental) |
langchain-core / langgraph | 1.6.10 / 1.2.15 |
| Model | gpt-6.1-sol, reasoning effort rendah |
git clone https://github.com/dzakybd/pid-parser
cd pid-parser && uv sync

# sekali saja: login dengan akun ChatGPT
uv run python -c "from langchain_openai.chatgpt_oauth \
  import login_chatgpt; login_chatgpt()"

mkdir -p work/skills
cp -R skills/pid-parser work/skills/ && cp drawing.png work/
uv run python agent/run.py work \
  --model gpt-6.1-sol --effort low --tiled
Inti run.py cukup pendek. Kode menjalankan tahap simbol dengan panggilan structured output biasa, satu per potongan, menulis graph.json, lalu menyerahkan sisanya ke sebuah Deep Agent. Versi ringkas dari agent/run.py:
from deepagents import create_deep_agent
from deepagents.backends import LocalShellBackend
from langchain_openai.chat_models.codex import _ChatOpenAICodex

model = _ChatOpenAICodex(
    model="gpt-6.1-sol", reasoning={"effort": "low"}
)

# Tahap 1 di kode: satu panggilan structured output
# per potongan, lalu gabungkan duplikat dari overlap
symbols, w, h = tile_symbols(model, "work/tiles")
graph = {"nodes": merge(symbols, w, h), "edges": []}
# ...disimpan sebagai work/graph.json

# Tahap 2 dst.: agen yang memuat SKILL.md yang sama
agent = create_deep_agent(
    model=model,
    system_prompt=SYSTEM,
    skills=["work/skills"],  # memuat skills/pid-parser/SKILL.md
    backend=LocalShellBackend(  # file dan shell sungguhan
        root_dir="work", virtual_mode=False
    ),
)
task = ("Steps 1-2 are done. Mark the ids, add the connections, "
        "validate and fix, then export.")
agent.invoke({"messages": [{"role": "user", "content": task}]})
Deep Agents menyediakan bagian yang tidak ingin saya tulis sendiri: memuat skill, memberi model tool file dan shell supaya bisa membuka gambar dan menjalankan skrip, dan menjaga loop tetap berjalan sampai hasil ekspor ada. Dua pengaturan ternyata penting. virtual_mode=False dengan path absolut di dalam tugas, karena tanpa itu agen tidak bisa menemukan skrip skill-nya. Dan pembagian kerjanya sendiri: kode mengerjakan simbol, agen mengerjakan pipa. Bagian tentang pipa di bawah menunjukkan apa yang terjadi ketika satu agen mengerjakan semuanya.
Saya sengaja memilih skill, bukan model yang dilatih. Detektor yang dilatih, seperti model Relationformer yang dirilis bersama PID2Graph, butuh data berlabel, GPU, dan training ulang kalau gaya gambarnya berubah. Skill hanyalah satu file teks dan empat skrip, dan ikut membaik ketika modelnya membaik.
Cara Saya Mengukurnya
Ada dua jenis pemeriksaan di proyek ini, dan keduanya mudah tertukar:
- Validator di langkah 6 berjalan setiap kali skill dipakai. Ia tidak tahu jawaban yang benar. Ia menerapkan aturan yang berlaku di P&ID mana pun, jadi yang tertangkap adalah graf yang rusak, bukan graf yang salah. Pipa yang tersambung ke katup yang keliru tetap lolos.
- Skor di bawah berasal dari ground truth. Saya menjalankan skill pada lembar yang graf benarnya sudah diketahui, lalu membandingkan keduanya dengan skrip yang deterministik. Tidak ada LLM yang menilai apa pun.
Saya sengaja tidak memakai LLM sebagai penilai. Vision model kedua yang membaca gambar yang sama punya titik buta yang sama: kalau model pertama melewatkan garis yang samar, model kedua bisa ikut melewatkannya lalu menganggap jawabannya benar. Selama kunci jawaban yang sebenarnya tersedia, itulah penilai yang lebih baik.
PID2Graph berisi lembar P&ID beserta graf yang benar untuk masing-masing lembar. Saya memakai lembar nyata dari bagian OPEN100 dan tiga lembar sintetis, dan hanya mengambil file-file itu dari arsip 9,3 GB lewat HTTP range request.
- Simbol: setiap kotak prediksi dipasangkan satu-satu dengan simbol yang benar kalau titik tengahnya cukup dekat. F1 simbol menunjukkan berapa yang ditemukan dan berapa yang dikarang.
- Koneksi: dua simbol dianggap terhubung kalau berada di jaringan pipa yang sama. F1 koneksi membandingkan pasangan-pasangan itu dengan yang benar. Inilah angka yang sulit.
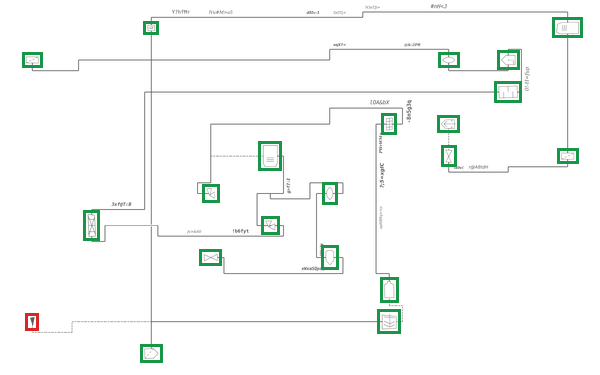
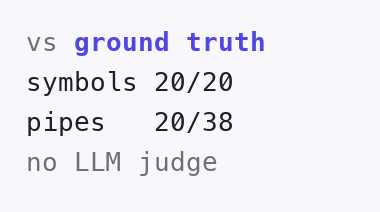
Begini tampilannya pada lembar yang hasilnya belum sempurna. Setiap simbol prediksi digambar di atas lembarnya: hijau kalau cocok dengan simbol di kunci jawaban, merah kalau kunci jawaban tidak punya apa-apa di situ. Ke-20 simbol yang benar semuanya ditemukan, ditambah satu yang berlebih. Pipanya lebih buruk: 20 dari 38 pasangan simbol yang benar. Angka ini cepat turun: satu pipa yang terlewat bisa memecah jaringan menjadi dua, dan setiap pasangan yang melintasi pecahan itu lalu dihitung terlewat.
Sebelum memercayai penilainya, saya mengujinya dulu: jawaban sempurna yang dibangun dari ground truth mendapat skor 1,0, membuang setiap simbol kelima menurunkan recall sesuai perkiraan, dan menggeser setiap kotak sebesar 3% dari diagonal lembar membuat F1 simbol anjlok.
| Konfigurasi | Lembar nyata: F1 simbol | Lembar nyata: F1 koneksi | Sintetis: F1 koneksi | Waktu per lembar |
|---|---|---|---|---|
| Deep Agents, gpt-6.1-sol, effort rendah | 0,91 | 0,80 | 0,83 | 3 sampai 6 mnt |
| Deep Agents, gpt-6.1-sol, effort sedang | 0,92 | 0,81 | 4 sampai 5 mnt | |
| Claude Code, Opus | 0,78 | 0,59 | 0,85 | 3 mnt |
| Codex, gpt-6-sol | 0,73 | 0,49 | 0,65 | 3 mnt |
Baris gpt-6.1-sol dijalankan pada dua lembar nyata, baris Claude Code dan Codex pada tiga, jadi kolom lembar nyata hanya perbandingan kasar. Setiap konfigurasi saya jalankan sekali per lembar, dan konfigurasi yang sama bisa berbeda sampai 0,2 antar-run. Effort rendah dan sedang skornya sama dalam batas noise itu, jadi effort rendah dijadikan default.
Kenapa Pipa Butuh Seluruh Lembar
Sebelum desain ini, saya mencoba membaca pipa per potongan lalu menyambung penggalannya: lewat simbol yang sama, lewat nomor line yang tercetak, dan dengan membawa ujung pipa ke potongan berikutnya. Semua versi itu skornya lebih rendah daripada membaca pipa dengan seluruh lembar terlihat. Pipa yang keluar dari satu potongan harus dicocokkan dengan penggalan yang benar di potongan berikutnya, dan satu kecocokan yang salah menggabungkan dua pipa yang di gambar sebenarnya terpisah.
Apakah model sekuat gpt-6.1-sol masih butuh kode untuk menjalankan tahap simbol? Saya mencobanya dengan dua cara, sekali per lembar. Di lembar nyata yang lebih sederhana hampir tidak ada bedanya: F1 koneksi 0,86 ketika agen menjalankan seluruh skill sendiri, 0,75 ketika kode yang menjalankan tahap simbol, masih dalam batas noise antar-run. Di lembar yang padat bedanya besar: 0,37 lawan 0,84. Hasil simbol kurang lebih sama di kedua cara; yang berbeda adalah pipanya. Ketika mengerjakan semuanya sendiri, agen menyelesaikan lembar padat itu dalam 8 tool call. Ketika simbol sudah dikerjakan kode, agen memakai 21 tool call hanya untuk pipa. Menyerahkan tahap simbol ke kode membuat agen bisa mencurahkan seluruh usahanya ke bagian yang sulit.
Sebuah tim di Imperial College London sampai pada pembagian yang sama secara independen. Paper ESCAPE 36 mereka membaca gambar dulu lalu membangun ulang topologinya di langkah kedua, dan itu menaikkan akurasi edge dari 55,6% menjadi 80,6% pada studi kasus pertama mereka.
Yang Belum Bisa
- Tag tidak dinilai. PID2Graph tidak menyertakan teks tag, jadi tag hanya saya periksa dengan mata. Anggap tag sebagai draf yang perlu ditinjau.
- Beberapa lembar bukanlah benchmark. Angka lembar nyata untuk gpt-6.1-sol berasal dari dua lembar. Angka itu menunjukkan metodenya bekerja; belum membuktikannya pada gambar Anda.
- Lembar yang padat masih jadi titik lemah. Header panjang yang menghubungkan dua puluh simbol adalah tempat setiap konfigurasi paling banyak kehilangan skor.
- Hasilnya bergantung pada model. Hasilnya membaik tanpa perubahan dari saya ketika modelnya membaik, dan model yang lebih lemah akan memberi hasil lebih buruk.
Coba Sendiri
- Pasang skill-nya:
npx skills add dzakybd/pid-parser, lalu minta agen Anda mem-parse sebuah gambar. - Lihat tiga lembar yang sudah dikonversi, lengkap dengan unduhannya, di Space showcase.
- Baca kode, penilai dan runner Deep Agents-nya: dzakybd/pid-parser.
Kalau Anda bekerja dengan P&ID: bagaimana tim Anda mengubah gambar menjadi data hari ini, manual, dengan tool vendor, atau belum sama sekali? Saya ingin tahu di mana alat ini cocok dan di mana tidak.
Referensi
- Dataset PID2Graph (CC BY-SA 4.0) dan papernya, arXiv 2411.13929. Gambar-gambar lembar P&ID di tulisan ini berasal dari bagian sintetisnya.
- Zhu, Duong, Vyas dan Mercangöz, From P&ID Drawings to Process Graphs: A Multimodal Language Model Approach, ESCAPE 36 (2026)
- LangChain Deep Agents dan login dengan ChatGPT
- skills CLI untuk
npx skills add - Kode dan showcase saya: dzakybd/pid-parser, Hugging Face Space