Dua Jenis PDF
Menghitung volume pekerjaan, memeriksa desain, dan merencanakan pekerjaan, semuanya berawal dari garis di sebuah gambar: dinding, bukaan, garis grid. Gambar itu biasanya datang sebagai PDF, dan PDF ada dua jenis. Kalau diekspor dari CAD, setiap garis masih tersimpan sebagai path vektor dengan koordinat yang tepat. Kalau hasil scan atau sudah diratakan, isinya hanya gambar, dan garisnya harus dicari ulang dari piksel.
Jadi pertanyaannya sederhana: kalau PDF masih menyimpan path-nya, apakah kita masih butuh computer vision? Dan kalau gambarnya hanya piksel, seberapa banyak yang hilang? Saya membuat floorplan-parser untuk menjawab keduanya dengan pengukuran, bukan opini: satu tool, dua extractor dengan output yang sama, dan benchmark yang menilai keduanya terhadap geometri gambar itu sendiri.
Kode: github.com/dzakybd/floorplan-parser (MIT) · Demo: huggingface.co/spaces/dzakybd/floorplan-parser
TL;DR
- Apa itu: CLI Python yang mengambil geometri garis dari PDF gambar, dengan membaca path vektor (PyMuPDF) atau dengan merender halaman lalu mencari garis memakai computer vision klasik (threshold dan Hough lines di OpenCV). Output JSON, CSV dan overlay-nya sama.
- Cara mengujinya: tiga gambar FloorPlanCAD uji (sederhana, sedang, padat). Masing-masing dijadikan satu PDF vektor dan PDF gambar pada 150, 300 dan 600 DPI, lalu dinilai berdasarkan panjang terhadap geometri SVG aslinya. Setelan jalur piksel hanya di-tuning pada gambar sintetis.
- Vektor: mendapatkan semua garis di ketiganya (F1 1,000), tetapi setiap busur kembali sebagai puluhan potongan lurus: 7.967 potongan untuk 807 garis di gambar padat.
- Piksel: F1 1,000, 0,890 dan 0,984 pada 300 DPI. Paling lemah ketika panel pintu digambar sebagai garis yang berjarak di bawah 2 pt, dan di sana resolusi lebih tinggi justru menambah garis yang salah.
- Catatan jujur: PDF vektor dibuat dari SVG yang sama dengan yang menilainya, jadi angka vektor yang hampir sempurna memang wajar. Yang menarik adalah apa yang tetap salah, dan berapa harga yang dibayar jalur piksel.
Membuat Perbandingannya Adil
Perbandingan seperti ini mudah dimiringkan. Beri satu metode input yang lebih bersih, atau tuning di gambar uji, dan hasilnya sudah ditentukan sebelum dijalankan. Karena itu setiap gambar melewati satu pipeline sebelum dilihat metode mana pun:
- Satu sumber. Setiap gambar berawal dari SVG FloorPlanCAD, kumpulan denah CAD nyata yang terbuka.
- Tidak ada jawaban di input. Label SVG (primitif mana yang dinding, mana yang pintu) dan semua teksnya dibuang. Gambar dibuat hitam di atas putih dan diskalakan ke halaman 800 × 800 pt.
- Dua file dari halaman yang sama. Gambar dikonversi sekali ke PDF vektor. PDF itu lalu dirender ke PDF berisi gambar saja pada 150, 300 dan 600 DPI, jadi jalur piksel melihat gambar yang persis sama.
- Kunci jawabannya adalah gambar itu sendiri. Ground truth adalah garis, busur dan lingkaran SVG asli dalam koordinat yang sama. Labelnya hanya dipakai lagi untuk memecah skor per kelas.
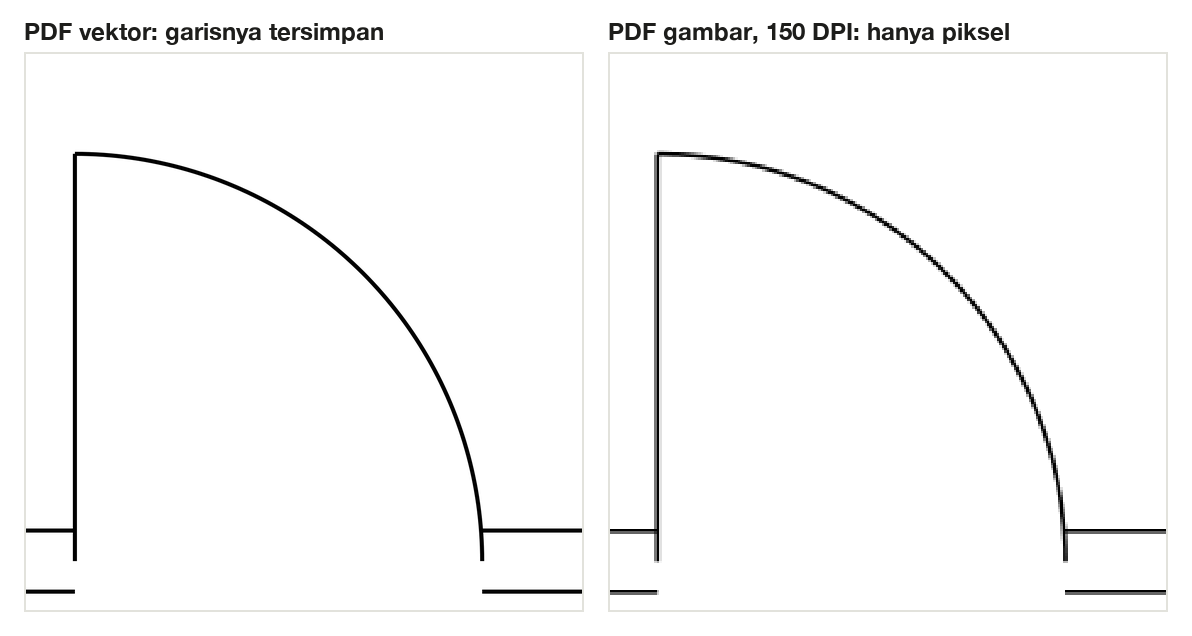
Halaman yang sama, dua file. Di kiri, busurnya tersimpan sebagai geometri; di kanan, hanya piksel, dan metodenya harus menebak di mana garis itu berada.
Catatan soal data: salinan FloorPlanCAD di Hugging Face hanya berisi gambar PNG tanpa SVG, jadi tidak bisa dipakai untuk perbandingan vektor. Saya memakai arsip uji asli dari situs proyeknya. Anotasinya berlisensi non-komersial dan penulisnya tidak memiliki gambar-gambar itu, jadi tidak ada gambar FloorPlanCAD di tulisan ini atau di tempat publik mana pun. Semua gambar di sini adalah gambar sintetis yang saya buat dengan gaya yang sama, dan hasil FloorPlanCAD hanya ditampilkan sebagai angka.
Dua Metodenya
Path vektor. page.get_drawings() di PyMuPDF mendaftar setiap path di halaman: garis lurus, kurva Bézier, persegi panjang. floorplan-parser memecah kurva menjadi potongan lurus pendek (galat 0,1 pt), memecah persegi panjang menjadi empat sisi, dan membuang garis ganda serta garis tanpa panjang. Tidak ada yang dideteksi; semuanya dibaca.
Piksel. Halaman dirender, atau kalau isinya satu gambar besar, didekode pada resolusi aslinya. Lalu:
- threshold menandai tinta;
- probabilistic Hough transform (
HoughLinesPdi OpenCV) mencari segmen lurus; - potongan yang terletak di garis yang sama digabung.
Panjang di setelannya memakai satuan point, jadi satu setelan berarti ukuran fisik yang sama di semua resolusi. Tanpa neural network dan tanpa training: satu-satunya tuning adalah grid search kecil atas lima parameter.
Keduanya menulis elements.json yang sama: setiap garis sebagai koordinat dalam point PDF, dengan kotak sumbernya, halamannya, dan metode yang menemukannya.
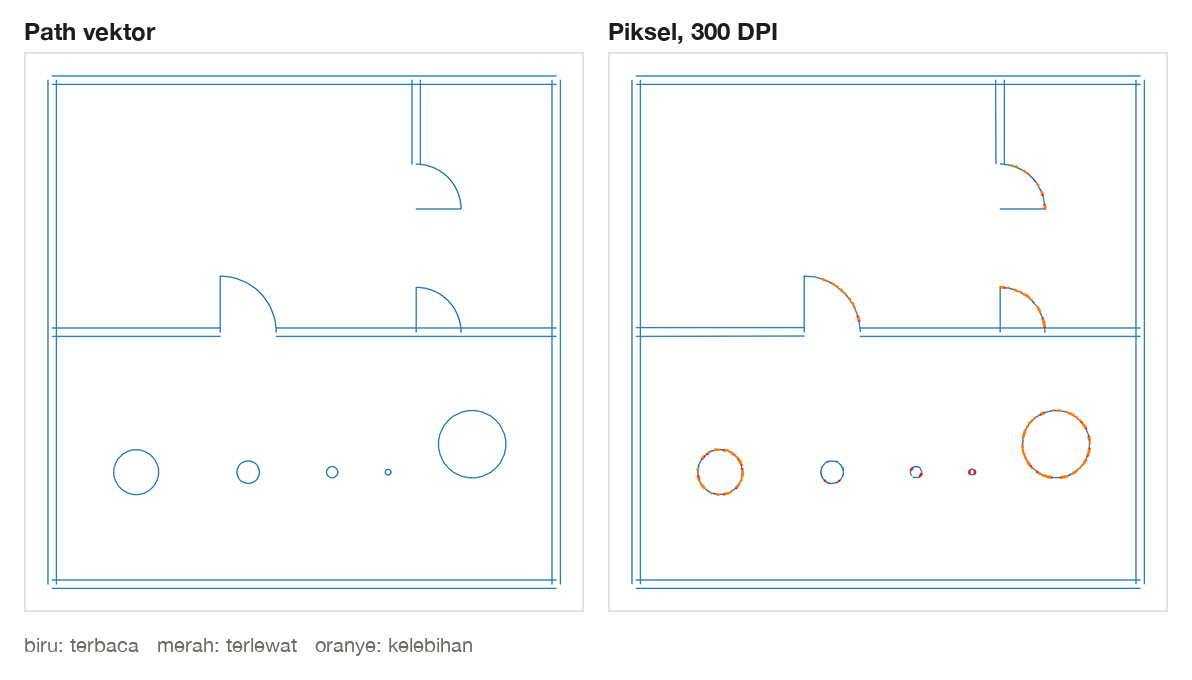
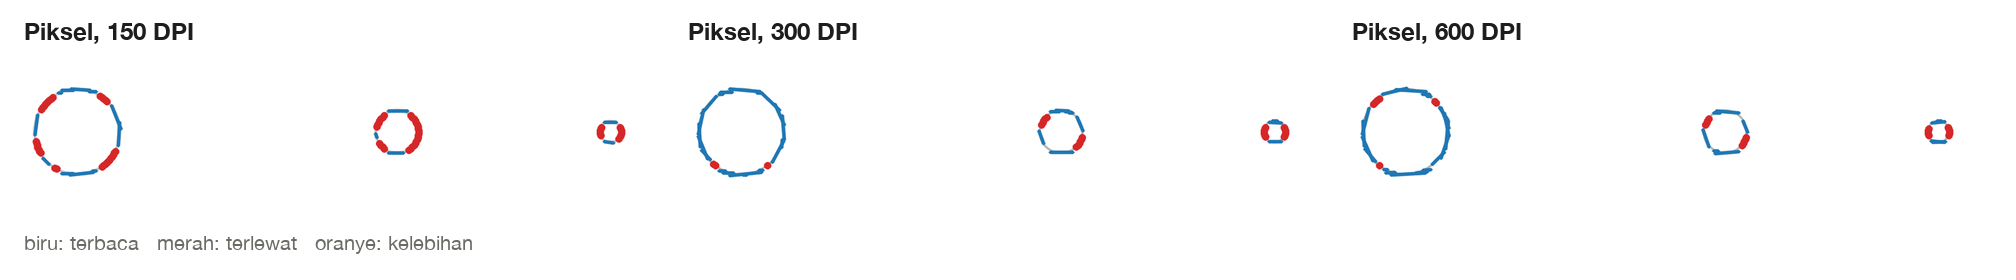
Biru adalah yang ditemukan tiap metode, merah garis yang terlewat, oranye garis yang ditambahkan. Jalur piksel hanya mengembalikan segmen lurus, jadi lingkaran menjadi cincin tali busur. Dari dekat, tali busur sedikit menyimpang dari arah kurva, dan skor menghitungnya sebagai kelebihan.
Cara Penilaiannya
Saya menilai berdasarkan panjang, bukan jumlah garis, karena kedua metode memecah garis dengan cara berbeda. Kedua set garis diambil sampelnya setiap 1 pt. Recall adalah porsi garis asli yang berada dalam 2 pt dan 5° dari garis hasil ekstraksi; precision adalah porsi garis hasil ekstraksi yang berada di garis asli. Dinding yang ditemukan dalam 50 potongan mendapat skor sama dengan dinding yang ditemukan utuh. Potongan yang lebih pendek dari 4 pt dicocokkan berdasarkan jarak saja, karena itu adalah kurva yang dipecah, dan dua cara memecah kurva tidak sepakat soal arah per potongan.
Scorer-nya diuji dulu sebelum menilai apa pun:
- set yang identik mendapat 1,0;
- garis yang dipecah jadi 50 potongan tetap 1,0;
- geseran 3 pt mendapat 0;
- garis yang memotong tegak lurus di bawah 0,05;
- setengah garis mendapat recall 0,5.
Setelan jalur piksel di-tuning pada lima gambar sintetis dan dibekukan sebelum gambar FloorPlanCAD dijalankan, sekali saja. Set sintetisnya ternyata mudah: setelan hasil tuning mendapat rata-rata F1 0,995 dibanding 0,993 untuk setelan bawaan, jadi tuning hampir tidak berpengaruh.
Hasil
Tiga gambar FloorPlanCAD uji, dipilih berdasarkan ukuran file: grid struktur yang sederhana, lembar sedang dengan pintu, tangga dan garis ganda yang rapat, serta denah apartemen yang padat.
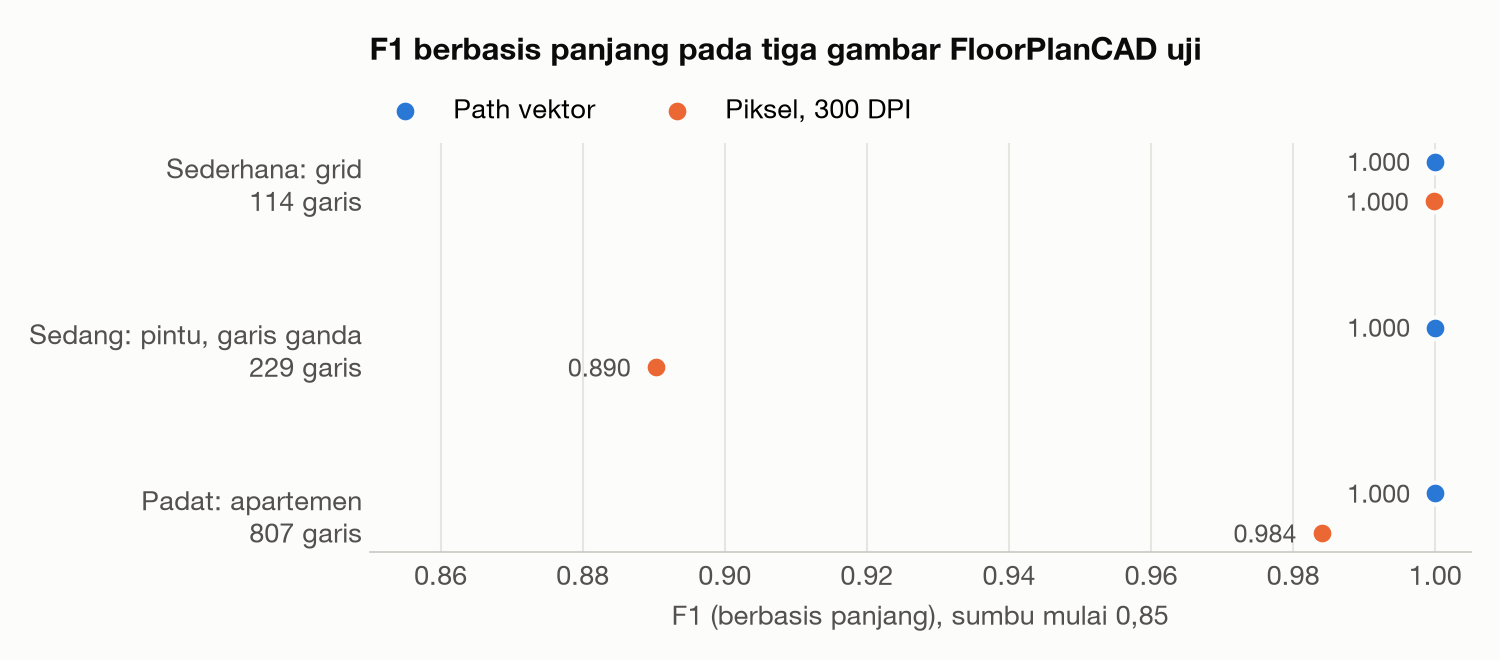
| Gambar | Garis asli | Path vektor | Piksel 150 DPI | Piksel 300 DPI | Piksel 600 DPI |
|---|---|---|---|---|---|
| Sederhana: grid struktur | 114 | 1,000 (114) | 0,999 (110) | 1,000 (102) | 1,000 (104) |
| Sedang: pintu, tangga, garis ganda | 229 | 1,000 (667) | 0,878 (1.217) | 0,890 (1.371) | 0,880 (1.675) |
| Padat: denah apartemen | 807 | 1,000 (7.967) | 0,976 (439) | 0,984 (515) | 0,985 (641) |
F1 berbasis panjang; jumlah potongan yang dikembalikan tiap metode ada di dalam kurung.
- Kecepatan: di dua gambar yang lebih sederhana, jalur vektor butuh 5 dan 21 ms dibanding 0,25 dan 0,39 detik untuk piksel 300 DPI. Di gambar padat keduanya setara, 0,38 detik dibanding 0,40 detik, karena jalur vektor harus membersihkan 7.967 potongan.
- Resolusi: di gambar padat, piksel yang lebih banyak membantu: galat panjang turun dari 9,0% pada 150 DPI ke 0,8% pada 600. Di gambar sedang terjadi sebaliknya (lihat bagian berikut).
- Scan yang sedikit miring atau berderau (sintetis, 300 DPI): memutar halaman 2° mengurangi F1 0,3 sampai 2,4 poin; derau plus blur menggesernya paling banyak 0,6.
Di Mana Masing-Masing Gagal
Vektor: garisnya benar, jumlahnya salah. Jalur vektor tidak pernah melewatkan garis di sini, tetapi mengembalikannya dalam potongan. MuPDF menyimpan busur sebagai rangkaian segmen lurus pendek, jadi di gambar padat 807 garis asli kembali sebagai 7.967 potongan, sekitar 10 per garis. Skornya berbasis panjang, jadi F1 tetap 1,000. Tetapi langkah yang menghitung dinding atau mengukur bukaan dari potongan itu akan meleset jauh sampai potongannya digabung.
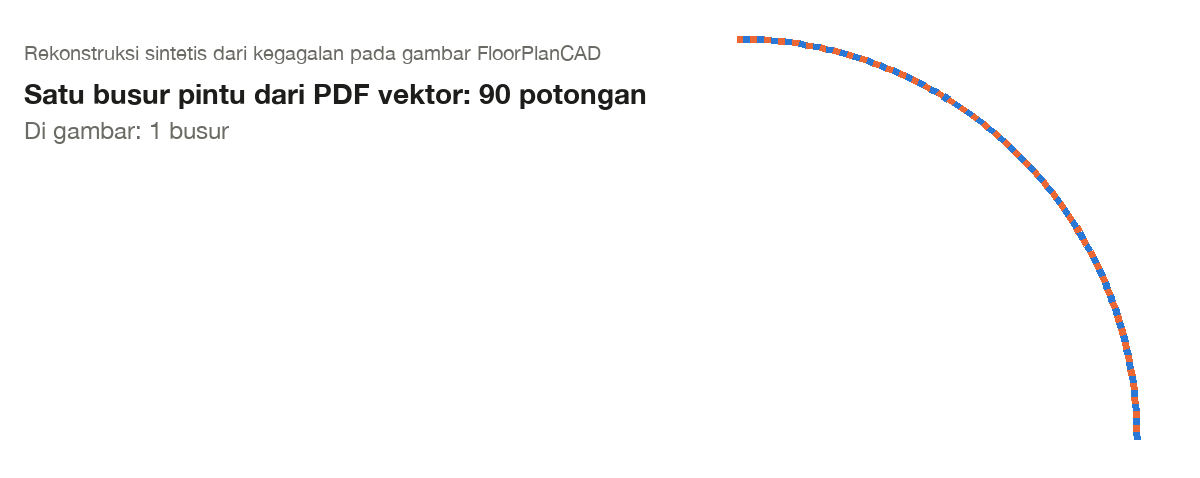
Hal yang sama di gambar sintetis: satu busur pintu, 90 potongan. Di gambar nyata, ini terjadi pada setiap busur.
Piksel: garis yang bertemu dengan jarak di bawah 2 pt. Di gambar sedang, setiap panel pintu dalam deretan pintu ganda digambar sebagai garis tepi tipis: dua sisi yang berjarak 1 sampai 2,4 pt (kurang dari satu milimeter di kertas), bertemu di sudut yang sama, sebagian digambar dua kali dengan warna berbeda. Di piksel, goresan-goresan itu menyatu menjadi satu gumpalan. Hough lalu menarik segmen menembus gumpalan itu ke arah yang tidak diikuti garis asli mana pun. Pada 300 DPI, sekitar 80% panjang kelebihan di gambar itu berada di garis pintu ganda, dengan jarak median hanya 0,3 pt dari garis asli: di atas tinta, tetapi dengan sudut yang salah. Resolusi lebih tinggi justru memperburuknya: precision turun dari 0,842 ke 0,817 dan galat panjang naik dari 2,8% ke 25,1% antara 150 dan 600 DPI. Pintu ganda juga kelas dengan recall terendah (0,890 pada 300 DPI). Saya mencoba membuat ulang kasus ini di gambar sintetis yang bersih dan tidak berhasil. Panel yang rapi dan berjarak rata terbaca dengan baik, jadi yang membuatnya gagal adalah garis nyata yang berantakan, dan saya tidak punya gambarnya yang boleh dibagikan.
Piksel: kurva kecil. Lingkaran kecil dan ujung busur pintu adalah tempat jalur piksel melewatkan garis. Lingkaran selebar beberapa point kembali sebagai beberapa tali busur, dan yang terkecil kehilangan sisi utuh.
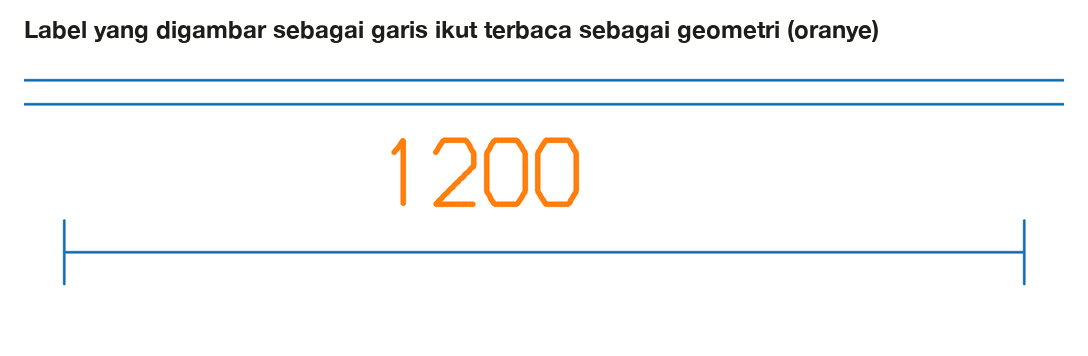
Keduanya: teks yang digambar sebagai garis. Ekspor CAD sering menggambar label dimensi sebagai goresan, bukan teks. Kedua metode lalu membacanya sebagai geometri. Di halaman sintetis dengan label "1200" yang digambar sebagai garis, semua metode mempertahankan recall 1,0 dan kehilangan precision, jalur vektor sampai 0,963. SVG FloorPlanCAD menyimpan teks secara terpisah, itulah kenapa gambar nyatanya tidak menunjukkan masalah ini. Banyak PDF nyata tidak begitu.
Bug saya sendiri, ketemu karena melihat overlay. Dua bug mengubah angkanya, dan keduanya sekarang punya test:
- Lingkaran kecil dinilai salah. Scorer pertama memeriksa arah di setiap potongan, jadi lingkaran kecil yang dipecah dengan dua cara berbeda terhitung sebagai garis kelebihan. Dari situ aturan 4 pt berasal.
- Dinding hasil gabungan jadi miring. Versi pertama penggabung potongan mengelompokkan potongan dengan merangkai sudut yang mirip. Potongan pendek yang dikembalikan Hough untuk sebuah lingkaran mencakup semua sudut, jadi rangkaian itu menyambungkan hampir semuanya, dan dinding digambar ulang mengikuti arah rata-rata yang miring. Ayunan pintu pada 600 DPI mendapat 0,34 sebelum diperbaiki.
Artinya dalam Praktik
- Kalau PDF masih punya path vektor, baca path-nya. Untuk mendapatkan garis, computer vision di sini hanya menambah galat: path-nya tepat dan, di gambar yang lebih sederhana, 19 sampai 49 kali lebih cepat dibaca. Siapkan langkah untuk menggabung potongan dan menyaring teks yang digambar sebagai garis.
- Kalau PDF hanya piksel, computer vision klasik sudah cukup jauh untuk gambar yang bersih, tanpa model yang perlu dilatih: F1 0,984 sampai 1,000 pada 300 DPI di gambar sederhana dan padat. Waspadai detail padat seperti panel pintu dan simbol rapat, tempat garis bertemu dengan jarak di bawah 2 pt. Di sana resolusi saja tidak membantu.
- Apa pun caranya, yang didapat adalah garis, bukan makna. Kedua metode tidak bisa membedakan dinding, pintu atau ruangan. Itu butuh langkah pengenalan terpisah di atasnya, pekerjaan untuk model terlatih atau aturan, dan memang untuk itulah dataset seperti FloorPlanCAD dibuat.
Batasan dan Langkah Berikutnya
| Batasan | Kenapa penting | Langkah berikutnya |
|---|---|---|
| Tiga gambar nyata | Menunjukkan perilaku metodenya, bukan akurasi umum | Jalankan set uji yang lebih besar, dibagi per kepadatan |
| PDF vektor dibuat dari SVG penilai | PDF hasil ekspor CAD menambah hatching, clipping dan layer | Uji pada PDF yang diekspor langsung dari tool CAD |
| Jalur piksel hanya garis lurus | Kurva kembali sebagai tali busur | Tambahkan deteksi lingkaran dan busur (Hough circles atau contour fitting) |
| Teks yang digambar sebagai garis tidak disaring | Label mengotori geometri | Deteksi kelompok goresan seukuran huruf, atau pakai layer teks PDF |
| Tidak ada makna | Garis belum berarti dinding atau pintu | Tambahkan langkah simbol atau segmentasi di atas garisnya |
Coba Sendiri
- Jalankan di gambar kamu:
uv run python -m floorplan_parser --input plan.pdf --method vector --output out/plan(instalasi dan opsi). - Bandingkan metode dan resolusi pada gambar sintetis di Space showcase.
- Jalankan ulang benchmark-nya: scorer, tuning dan semua file hasil ada di repo.
Kalau kamu bekerja dengan PDF gambar: berapa banyak yang masih punya path vektor, dan berapa banyak yang hasil scan? Jawaban itu menentukan setengah bagian mana dari tulisan ini yang relevan buat kamu.
Referensi
- Z. Fan, L. Zhu, H. Li, X. Chen, S. Zhu, P. Tan, FloorPlanCAD: A Large-Scale CAD Drawing Dataset for Panoptic Symbol Spotting, ICCV 2021. Anotasi CC BY-NC 4.0. Nama kelas mengikuti
config/anno_config.pydi VITA-Group/CADTransformer. - R. O. Duda dan P. E. Hart, "Use of the Hough Transformation to Detect Lines and Curves in Pictures", Communications of the ACM, 1972. J. Matas, C. Galambos dan J. Kittler, "Robust Detection of Lines Using the Progressive Probabilistic Hough Transform", Computer Vision and Image Understanding, 2000.
- PyMuPDF
Page.get_drawings()dan OpenCVHoughLinesP.