AI yang Melatih Modelnya Sendiri
Maret 2026, Andrej Karpathy membiarkan sebuah agen AI bekerja sendiri dengan satu model bahasa kecil dan satu GPU selama sekitar dua hari. Tidak ada yang memberi tahu agen itu apa yang harus dicoba. Agen itu mengubah kode training, melatih model selama lima menit, mempertahankan perubahan kalau modelnya membaik, membuangnya kalau tidak, lalu mengulanginya. Berbagai ulasan menyebut jumlahnya sekitar 700 eksperimen. Hasilnya, agen itu menemukan sekitar 20 perbaikan yang bisa ditumpuk, dan bersama-sama perbaikan itu membuat modelnya 11% lebih cepat mencapai kualitas GPT-2.
Karpathy menamainya autoresearch, dan idenya kini menyebar ke hampir semua bidang yang punya angka untuk didorong. Saya ingin tahu apa saja yang dibutuhkan untuk memakainya di pekerjaan sendiri, jadi saya membangun sebuah loop untuk recommender dan menjalankan 185 eksperimen. Hasilnya, Recall@10 naik dari 15% menjadi 73%. Angka 15% itu berasal dari baseline yang menampilkan sepuluh toko terpopuler yang sama untuk semua orang. Lebih dari itu, saya jadi tahu apa yang sebenarnya diberikan loop seperti ini: setiap ide dicoba, setiap hasil diukur, setiap kegagalan dibatalkan, dan riwayat git menjelaskan bagaimana hasil akhirnya tercapai.
TL;DR
- Apa itu: autoresearch dari Karpathy menyerahkan loop eksperimen ke agen. Satu file yang boleh diubah, satu evaluator yang dikunci, satu angka, git sebagai memori.
- Cara memakainya: dengan skill uditgoenka kita menulis enam field (Goal, Scope, Metric, Direction, Verify, Guard) plus budget, lalu ia menjalankan iterasi keep-or-revert sendiri.
- Apakah berhasil: di sebuah tugas recommender publik, 185 eksperimen menaikkan Recall@10 dari 15% menjadi 73%.
- Jebakannya: loop mengoptimalkan juri apa pun yang kita berikan. Kunci jurinya, taruh statistik di aturan keep, dan baca log-nya.
Kenapa Saya Butuh Mesin untuk Ini
Sebagian besar waktu saya di sebuah masalah ML tidak habis untuk mencari ide. Waktunya habis di loop di sekitar ide itu. Ubah satu hal, jalankan, tunggu, baca angkanya, putuskan apakah membantu, kembalikan kalau tidak, lalu ingat apa saja yang sudah dicoba. Loop itu mekanis, dan justru bagian itulah yang paling buruk saya kerjakan jam 11 malam.
Autoresearch menyerahkan loop itu sepenuhnya ke mesin. Versi Karpathy memberi agen "a small but real LLM training setup" dan membiarkannya "experiment autonomously overnight".
Sisa tulisan ini mengikuti tiga diagram animasinya:
- Apa itu. Versi asli Karpathy: tiga file, loop tujuh langkah, alasan di balik setiap keputusan desain, apa yang ditemukan, dan di mana kelemahannya.
- Cara memakainya. Skill uditgoenka/autoresearch yang saya pakai di Claude Code: enam field yang harus didefinisikan, apa yang terjadi di setiap iterasi, dan pagar pengamannya.
- Apakah berhasil? Loop buatan saya sendiri untuk sebuah recommender: masalahnya, modelnya, metriknya, lima run, dan pelajaran dari log-nya.
Bagian 1: Apa Itu Autoresearch
Versi singkatnya: satu file yang boleh diubah agen, satu juri yang tidak bisa ia sentuh, satu angka, dan git untuk mengingat apa yang berhasil.
Idenya dalam satu paragraf
Beri agen sebuah setup eksperimen yang kecil tapi nyata. Izinkan ia mengubah tepat satu file. Kunci evaluasinya di file yang tidak bisa ia sentuh. Nilai setiap percobaan dengan satu angka di bawah budget yang tetap. Commit setiap percobaan ke git, pertahankan commit-nya kalau angkanya membaik dan reset kalau tidak, catat satu baris log di kedua kasus, lalu ulangi sampai manusia menghentikannya. Pekerjaan manusia bergeser dari menjalankan eksperimen ke menulis instruksi dan jurinya.
Tiga file
| File | Siapa yang mengubah | Isinya |
|---|---|---|
prepare.py | tidak ada (read-only) | unduh data, training tokenizer, dataloader, dan fungsi evaluasi |
train.py | agen, dan hanya agen | model GPT, optimizer (Muon + AdamW), dan training loop; "everything is fair game" |
program.md | manusia | instruksi untuk agen; Karpathy menyebutnya "a super lightweight skill" |
Metriknya val_bpb (validation bits per byte), makin kecil makin baik. Karena diukur per byte dan bukan per token, metrik ini tidak bergantung pada ukuran vocabulary. Perubahan arsitektur dan perubahan tokenizer jadi berada di skala yang sama.
Loop-nya, langkah demi langkah
program.md itu pendek, dan setiap barisnya punya fungsi.
- Siapkan branch. Pilih tag dari tanggal hari ini lalu buat
autoresearch/<tag>dari master. Baca ketiga file. Buatresults.tsvyang isinya hanya baris header. - Buat satu perubahan. Ubah
train.pydengan satu ide, lalu commit. - Jalankan dengan budget tetap.
uv run train.py > run.log 2>&1. Training berhenti di lima menit waktu nyata, tidak termasuk startup. Output masuk ke file, bukan ke konteks agen, supaya log yang panjang tidak membanjiri memorinya. - Baca satu angka.
grep "^val_bpb:\|^peak_vram_mb:" run.log. Kalau kosong berarti crash. Baca 50 baris terakhir, perbaiki kalau cuma salah ketik, dan tinggalkan idenya kalau memang rusak dari dasarnya. - Catat. Tambahkan satu baris ke
results.tsvberisi hash commit pendek,val_bpb, memori puncak dalam GB, status (keep,discard, ataucrash), dan deskripsi satu kalimat. File log ini sendiri tidak di-commit. - Putuskan. Kalau
val_bpbmembaik, commit dipertahankan dan branch maju. Kalau sama atau lebih buruk,git resetke titik awal. - Jangan pernah berhenti. Jangan berhenti untuk bertanya apakah perlu lanjut. Terus usulkan ide, baca ulang file, dan gabungkan percobaan yang nyaris berhasil sampai manusia menghentikannya. Run yang lebih dari 10 menit dimatikan dan dihitung gagal.
Kenapa dirancang seperti ini
Setiap keputusan desain menutup satu cara spesifik loop tanpa pengawasan bisa salah arah.
- Budget waktu yang tetap, bukan jumlah langkah yang tetap. Setiap eksperimen dapat lima menit yang sama, jadi model besar dan model kecil dibandingkan berdasarkan apa yang bisa dicapai dalam waktu yang sama. Konsekuensinya, hasil terikat ke GPU yang dipakai dan tidak bisa dibandingkan antar-mesin.
- Satu file yang boleh diubah. Dampak setiap perubahan terbatas pada satu file, dan setiap perubahan yang dipertahankan adalah diff yang bisa dibaca manusia dalam semenit.
- Evaluator yang dikunci. Agen boleh membaca
prepare.pytapi tidak boleh mengubahnya. Ini aturan terpenting di repo itu. Loop yang bisa mengubah jurinya sendiri lama-lama akan mengoptimalkan jurinya, bukan modelnya (Bagian 3 punya contoh persis seperti itu). - Git sebagai memori. Setiap percobaan adalah commit, dan kegagalan di-reset. Riwayat branch menjadi buku catatan lab berisi apa saja yang bertahan, dan agen membacanya ulang untuk memutuskan apa yang dicoba berikutnya.
- Aturan kesederhanaan. Kenaikan kecil yang menambah kode berantakan belum tentu layak dipertahankan, dan hasil yang sama dengan kode yang lebih sedikit dihitung sebagai kemenangan. Tanpa aturan ini, loop menumpuk hack yang masing-masing hanya menggeser metrik karena noise.
- Jangan pernah berhenti. Tujuannya adalah berjalan selagi kita tidur. Agen yang dengan sopan bertanya "lanjut?" jam 2 pagi sudah gagal di satu-satunya tugasnya.
Apa yang ditemukan
README-nya menampilkan chart progres semalam milik Karpathy: 83 eksperimen, 15 dipertahankan, dengan val_bpb turun dari sekitar 0,998 ke sekitar 0,977. Perubahan yang dipertahankan adalah tuning biasa, seperti memotong total batch size jadi setengah, warmdown yang lebih panjang, attention window yang lebih pendek, dan RoPE base frequency yang lebih besar.
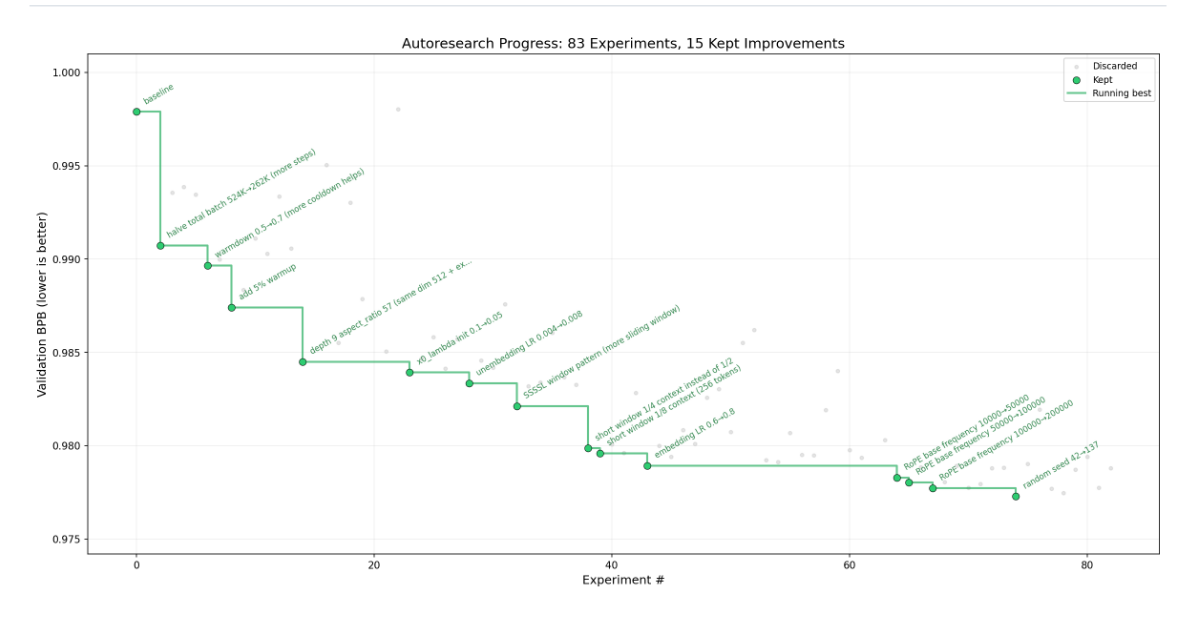
Chart progres milik Karpathy sendiri, dari README autoresearch. Tangga hijau adalah commit yang dipertahankan, titik abu-abu yang dibuang.
Run yang lebih panjanglah yang menarik perhatian. Karpathy membiarkannya jalan sekitar dua hari pada model nanochat depth-12. Berbagai ulasan menyebut jumlahnya sekitar 700 eksperimen. Agen menemukan sekitar 20 perubahan yang menurunkan validation loss. Semuanya bisa ditumpuk, semuanya tetap berlaku di model depth-24, dan bersama-sama memangkas "time to GPT-2" di leaderboard nanochat dari 2,02 jam menjadi 1,80 jam, sekitar 11%. Ini bukan terobosan. Ini jenis tuning yang akan ditemukan engineer yang teliti dalam seminggu, bedanya ditemukan tanpa ada yang menunggui.
Di mana kelemahannya
Panduan Datacamp merangkum batasannya dengan baik, dan sebagian besar saya alami sendiri di Bagian 3.
- Mekanisme ratchet punya batas kreativitas. Ia hanya menerima kenaikan langsung, jadi tidak bisa mundur selangkah untuk mencapai sesuatu yang lebih baik. Ia cenderung berputar di variasi kecil dari yang sudah berhasil.
- Lima menit menyembunyikan efek jangka panjang. Perubahan yang baru terasa setelah sejam training akan terlihat seperti kemunduran.
- Banyak eksperimen membuat validation set overfit. Setelah ratusan pilihan di data yang sama, sebagian kenaikannya hanya berlaku untuk data itu.
- Evaluasi menjadi hambatan. Begitu eksperimen murah, kualitas juri yang membatasi kita.
Dari satu repo menjadi ekosistem
Daftar awesome-autoresearch sekarang mencatat puluhan turunan. Yang penting terbagi ke tiga generasi, dan bedanya terutama di apa yang boleh disentuh agen dan siapa yang menilainya:
| Versi asli Karpathy | Skill umum (uditgoenka) | Pipeline riset (ARIS, Agon) | |
|---|---|---|---|
| Yang diubah agen | hanya train.py | file apa pun yang cocok dengan glob Scope | kode, eksperimen, draf paper |
| Dinilai oleh | val_bpb setelah run 5 menit | perintah Verify, plus Guard yang harus tetap lulus | model kedua atau peran reviewer |
| Dipakai untuk | training LLM kecil | test coverage, latency, ukuran bundle, kernel | dari ide sampai paper |
Port dari versi asli menjalankan loop yang sama di Apple Silicon, MLX, GPU Windows, WebGPU, dan T4 gratis di Colab. Alat umum membuang skrip training dan mempertahankan kontraknya. Contoh paling jelas datang dari Shopify. Engineer mereka membuat pi-autoresearch, melaporkan sudah memakainya untuk lebih dari 40 metrik, dan memangkas build time yang menjadi gerbang semua pipeline CI sebesar 65%. Ada dua detail yang membekas buat saya. Prompt sekali jalan "Improve Polaris build time" gagal, sedangkan loop dengan metrik yang jelas berhasil. Lalu Tobi Lütke sendiri menyebut hasil Liquid-nya (parse dan render 53% lebih cepat) "probably somewhat overfit".
Pipeline riset melangkah paling jauh. ARIS (Auto-Research-In-Sleep) adalah kumpulan skill berbentuk Markdown biasa yang eksekutor dan reviewer-nya model berbeda. Claude Code mengerjakan, Codex mereview, sehingga satu model tidak menilai titik butanya sendiri. Agon membagi pekerjaan ke peran scientist, coder, auditor, dan reviewer, dan setiap serah terima lewat file di disk. Makin ke kanan di tabel itu, makin lunak metriknya. Sebuah survei terhadap 56 sistem riset otonom menyimpulkan bahwa sistem-sistem ini sudah meningkatkan apa yang bisa mereka hasilkan, tapi belum apa yang bisa mereka pertanggungjawabkan, dan verifier yang paling umum dipakai, yaitu LLM sebagai juri, justru yang paling lemah.
Bagian 2: Cara Memakainya dengan Skill uditgoenka
Versi singkatnya: kita menulis enam baris config. Agen mengerjakan sisanya, satu commit setiap kali, dan berhenti saat budget habis.
Untuk pekerjaan engineering sehari-hari saya memakai skill uditgoenka. Skill ini mempertahankan kontrak Karpathy (satu scope, satu angka, keep atau revert, git sebagai memori) dan membuang semua yang khusus untuk training LLM.
Instalasi
# Claude Code, sebagai skill
npx skills add uditgoenka/autoresearch

# atau sebagai plugin Claude Code
/plugin marketplace add uditgoenka/autoresearch
/plugin install autoresearch@autoresearch

# atau lewat installer bawaan (juga mendukung --opencode dan --codex)
./scripts/install.sh --claude --global
Mulai sesi baru setelah instalasi. Di OpenCode perintahnya memakai garis bawah (/autoresearch_debug), dan di Codex berupa kata kunci ($autoresearch plan).
Enam hal yang kita definisikan
| Field | Artinya | Contoh | Akibatnya kalau tidak ada |
|---|---|---|---|
Goal | apa yang kita mau, dengan kata-kata biasa | menaikkan coverage test parser | agen tidak punya arah untuk bernalar |
Scope | file yang boleh diubah agen | src/parser/**/*.ts | agen keluyuran ke kode yang tidak dimaksud |
Metric + Direction | satu angka, dan arah mana yang lebih baik | coverage baris dalam %, makin tinggi | "lebih baik" jadi soal pendapat |
Verify | perintah shell yang mencetak angka itu | npm run test:coverage ... | node pct.js | tidak ada yang bisa dinilai, jadi tidak ada keep atau revert |
Guard | perintah yang harus tetap lulus | npm test | metriknya naik sementara hal lain rusak |
Iterations | budget-nya | 25 (default) | loop tanpa batas, yang seharusnya dipilih secara sadar |
Kalau digabung, config-nya seperti ini:
/autoresearch
Goal: raise line coverage of the parser module
Scope: src/parser/**/*.ts
Metric: line coverage % from the coverage summary
Direction: higher
Verify: npm run test:coverage -- --silent | node scripts/coverage-pct.js
Guard: npm test
Iterations: 25
Kalau diterapkan ke recommender di Bagian 3, enam field yang sama kira-kira berbunyi seperti ini. Ini hanya ilustrasi: skrip yang disebut di sini tidak ada di repo, karena studi kasus saya memakai loop Python sendiri dengan aturan yang sama.
/autoresearch
Goal: recommend the right store more often
Scope: experimenter.py (model and feature code only)
Metric: validation Recall@10
Direction: higher
Verify: uv run python eval_val.py        # prints the validation score
Guard: ./check_eval_unchanged.sh         # evaluator and test split must not change
Iterations: 50
Biarkan /autoresearch:plan menurunkannya
Field yang paling sulit adalah Verify, yaitu perintah yang mengubah "lebih baik" menjadi satu angka secara andal. Kalau saya belum yakin, saya jalankan /autoresearch:plan dengan tujuan yang ditulis biasa. Ia bekerja dalam tujuh fase. Ia menganalisis apakah tujuannya bisa diukur, menurunkan scope dari struktur proyek, mengusulkan metrik dan arahnya, menyusun perintah verify, menjalankan perintah itu sekali untuk membuktikan ia mencetak angka, mengusulkan guard (test suite, type check, atau build), lalu menyarankan jumlah iterasi. Hasil akhirnya blok config yang siap dijalankan, dan ia bertanya apakah mau langsung dijalankan atau diubah dulu. Untuk tujuan yang tidak punya angka yang jujur, ia mengarahkan ke /autoresearch:reason.
Apa yang terjadi saat kita menekan enter
Sebelum iterasi pertama, skill memeriksa bahwa kita ada di git repo dengan working tree yang bersih, menjalankan guard sekali untuk mendapat baseline, dan menyaring perintah Verify dari pola berbahaya (rm -rf, curl | sh, kredensial yang tertanam). Lalu ia menjalankan Verify sekali dan mencatatnya sebagai iterasi 0, yaitu baseline.
Setiap iterasi sesudahnya punya tujuh fase.
- Review. Baca ekor file hasil dan
git log --oneline -20. Kalau iterasi terakhir dipertahankan, baca diff-nya untuk melihat apa yang membantu. - Modify. Buat satu perubahan yang fokus dan atomik.
- Commit. Commit dengan prefix
experiment:, sebelum tahu apakah berhasil. - Verify. Jalankan perintah
Verifydan hitung delta-nya. - Guard. Jalankan guard. Kalau gagal, perubahan tidak dipertahankan meskipun metriknya naik.
- Decide.
keep,discard,crash,no-op,hook-blocked, ataumetric-error. Semua selainkeepdibatalkan dengangit revert. - Log. Tambahkan satu baris, lalu ulangi.
Semua hasil masuk ke autoresearch/loop-<tanggal>-<jam>/. File hasilnya berformat TSV biasa, jadi bisa dibaca pagi harinya, di-diff, atau diberikan ke /autoresearch:evals:
# metric_direction: higher_is_better
iteration  timestamp  commit   metric  delta  guard  guard-metric  status    description
0          ...        a1b2c3d  71.8    0.0    pass   -             baseline  initial state
1          ...        e4f5a6b  73.1    +1.3   pass   -             keep      tests for empty input
2          ...        c7d8e9f  72.9    -0.2   pass   -             discard   parametrize token cases
Contoh file hasil. Kolomnya sesuai skill, angkanya karangan untuk ilustrasi.
Pagar pengamannya justru intinya
Bagian yang paling saya hargai justru yang membosankan. Di Claude Code, sekitar sepuluh hook aktif secara default. Hook itu memblokir pembacaan file .env dan kredensial, memblokir force push dan hard reset, melewati folder berat seperti node_modules, memberi peringatan di 400 baris perubahan, dan memblokir di 800 baris. Skill ini tidak pernah push atau deploy tanpa bertanya. Iterasi dibatasi kecuali kita menulis Iterations: unlimited. Kalau sebuah loop akan jalan sejam tanpa saya, batasan-batasan inilah yang membuat saya berani meninggalkannya.
Loop-loop lainnya
Skill yang sama punya tiga belas perintah lain dengan ide serupa, yaitu loop yang dibatasi dengan kondisi berhenti yang mekanis.
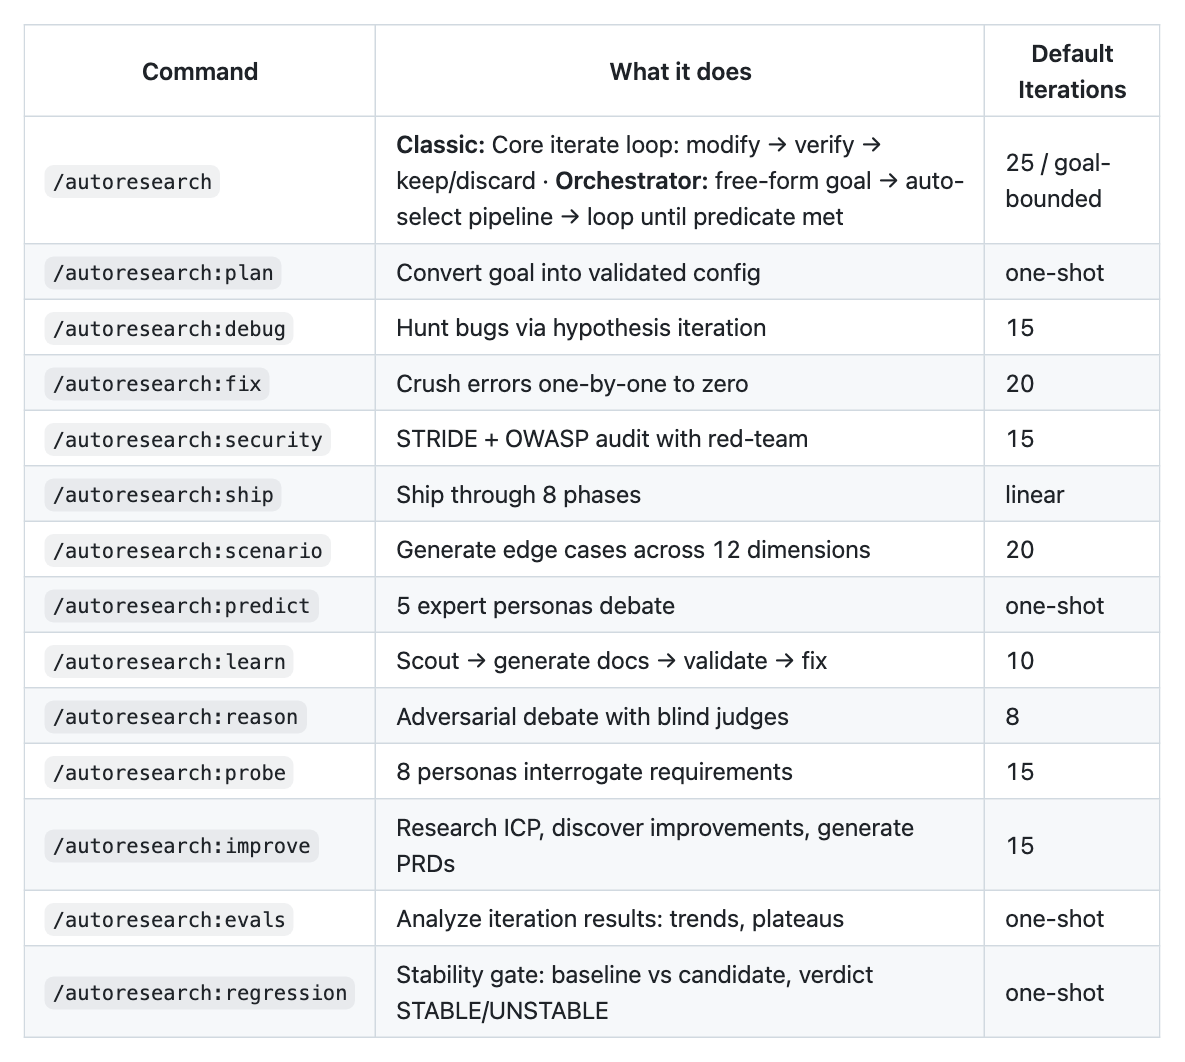
Tabel perintah dari README uditgoenka/autoresearch.
Yang paling sering saya pakai adalah :plan untuk menyiapkan loop, :fix untuk menghabisi error test, type, dan lint sampai nol, :debug untuk berburu bug berbasis hipotesis, dan :regression sebagai gerbang stabil-atau-tidak sebelum push. Perintah bisa dirangkai (--chain fix,regression), dan --evals menambahkan checkpoint yang menandai plateau dan menyarankan berhenti lebih awal. Sejak v2.2, /autoresearch juga bisa diberi tujuan dengan bahasa biasa tanpa metrik. Orchestrator lalu mengklasifikasikan tujuannya, menurunkan predikat lulus-gagal, meminta konfirmasi sekali, dan berpindah antar-subperintah sampai predikat terpenuhi atau mentok.
Kebiasaan yang membuatnya bekerja
- Buat
Verifycepat dan deterministik. Angka yang noisy membuat loop menaiki tangga keberuntungan. Kalau metriknya noisy, rata-ratakan beberapa run di dalam perintahnya. - Taruh test di
Guard, bukan diScope. Agen tidak boleh bisa membuat guard lulus dengan mengubahnya. - Jaga scope tetap kecil. Satu modul lebih baik daripada seluruh repo. Diff yang kecil adalah diff yang benar-benar akan kita baca.
- Baca diff yang dipertahankan. Git membuatnya murah. Dari situlah kita menangkap agen yang menang dengan cara yang tidak kita maksud.
Varian lain yang layak diketahui
Skill uditgoenka hanyalah salah satunya. Daftar awesome-autoresearch mencatat puluhan varian. Berikut yang akan saya lihat lebih dulu, tergantung alat yang dipakai dan seberapa jauh loop-nya ingin dibawa:
| Proyek | Jalan di | Yang ditambahkan |
|---|---|---|
| uditgoenka/autoresearch | Claude Code, OpenCode, Codex | yang dibahas di tulisan ini: config enam field, 14 perintah, hook pengaman |
| codex-autoresearch | Codex | run yang bisa dilanjutkan, pelajaran yang dibawa antar-run, eksperimen paralel |
| gemini-autoresearch | Gemini CLI | search grounding dan run semalaman tanpa antarmuka |
| pi-autoresearch | pi | loop yang persisten dan bisa dilanjutkan, lengkap dengan dashboard |
| research-loop | skill agen | runner deterministik, git worktree terisolasi, dan catatan eksperimen yang hanya bisa ditambah |
| goal-md | agen apa pun | file GOAL.md yang membuat agen menyusun fungsi fitness terukur sebelum mengoptimalkan |
| ARIS | Claude Code, Codex, dan lainnya | 82 skill Markdown dari ide dan pencarian literatur sampai eksperimen, paper, dan rebuttal, dengan model kedua yang mereview model pertama |
| Agon | plugin Claude Code | dari topik ke ide, proposal, lalu eksperimen, dengan peran scientist, coder, auditor, dan reviewer, dan setiap serah terima disimpan sebagai file |
| AI-Scientist-v2 | mandiri | pipeline end-to-end dari Sakana, dari ide sampai paper, memakai tree search |
Enam yang pertama mempertahankan bentuk autoresearch, yaitu satu metrik dan keep atau revert. ARIS, Agon, dan AI-Scientist memperluas loop-nya ke seluruh siklus riset. Kemampuannya besar, tapi jurinya jadi lebih lunak, misalnya model reviewer.
Bagian 3: Apakah Berhasil? Studi Kasus Recommender
Versi singkatnya: 185 eksperimen, 13 perubahan yang dipertahankan, dan Recall@10 naik dari 15% menjadi 73%.
Skill itu bagus kalau yang dioptimalkan adalah kode dan metriknya murah. Saya ingin melihat apa yang dilakukan teknik yang sama pada pertanyaan ML klasik, jadi saya membuat loop kecil sendiri dengan Python. Kode dan semua log run-nya ada di GitHub.
Masalahnya
Dari aktivitas seseorang di beberapa bagian sebuah super-app, sinyal mana yang benar-benar memprediksi pembelian berikutnya di satu vertical, terutama untuk pengguna yang hampir belum pernah memakainya? Saya memakai check-in Foursquare NYC yang publik sebagai proxy. Isinya 227 ribu check-in dari 1.083 pengguna, dipetakan ke tiga vertical. Food berisi restoran dan kafe, Mart berisi deli, bodega, apotek, dan pasar, sedangkan Shops berisi retail lainnya. Tugasnya merekomendasikan venue Mart berikutnya untuk tiap pengguna dari 705 kandidat.
Metriknya
Pertanyaan yang saya pedulikan sederhana: apakah toko yang benar-benar didatangi pengguna berikutnya ada di 10 besar rekomendasinya? Persentase pengguna yang jawabannya "ya" disebut Recall@10. Rentangnya 0% sampai 100%, dan makin tinggi makin baik.
Loop-nya sendiri menilai setiap perubahan dengan NDCG@10, versi yang lebih ketat dari ide yang sama. NDCG@10 juga memberi nilai lebih kalau toko yang benar berada di urutan atas: 1,0 di peringkat 1, 0,5 di peringkat 3, 0,29 di peringkat 10, dan 0 di luar 10 besar. Mengoptimalkan angka yang lebih ketat inilah yang menaikkan keduanya.
Untuk setiap dari 721 pengguna yang punya minimal dua kunjungan Mart, kunjungan kedua terakhir dipakai untuk tuning (validasi) dan kunjungan terakhir disimpan terpisah (test). Semua keputusan loop dibuat di validasi. Kunjungan test dinilai sekali di akhir setiap run, jadi hasil di bawah berasal dari kunjungan yang tidak pernah dilihat loop.
Model dan ruang pencariannya
Modelnya terdiri dari satu recommender dasar plus enam kandidat fitur, yang di bawah saya sebut sinyal. Setiap fitur awalnya mati, lalu loop yang memutuskan apakah fitur itu dinyalakan dan seberapa besar bobotnya. Loop tidak pernah menulis ulang kode. Setiap iterasi mengubah tepat satu hal di config:
| Knob | Yang dikendalikan |
|---|---|
| base model | popularity, ItemKNN, EASE, atau RP3beta (random walk di graf pengguna-venue, yang menyarankan toko yang didatangi orang-orang yang sering ke tempat yang sama dengan kita), beserta parameternya |
cross | seberapa besar riwayat Food dan Shops dihitung di samping riwayat Mart |
geo | kedekatan dengan area biasa pengguna (median semua tempat yang pernah didatangi) |
here | kedekatan dengan check-in terakhir pengguna, yaitu posisinya sekarang (ditambahkan di run 2) |
local | venue yang populer di sekitar check-in terakhir itu (ditambahkan di run 5) |
repeat | boost untuk venue yang pernah dikunjungi |
seq | attention atas lima check-in terakhir |
Kreativitas edit kode bebas memang hilang. Gantinya, setiap eksperimen selesai jauh di bawah satu detik, dan loop tidak mungkin merusak evaluator karena tidak pernah menyentuh kode.
Aturan keep
Dengan 721 pengguna, kenaikan kecil di rata-rata NDCG bisa murni noise, dan loop yang menyimpan noise akan menaiki tangga keberuntungan. Jadi sebuah perubahan hanya dipertahankan kalau rata-ratanya naik dan paired bootstrap atas pengguna menyatakan kenaikan itu nyata dengan probabilitas minimal 0,90:
def p_improve(new, old, n=2000, seed=0):
    """Paired bootstrap over users: P(mean NDCG delta > 0) and a 95% CI of the delta."""
    d = new - old
    means = d[np.random.default_rng(seed).integers(0, len(d), (n, len(d)))].mean(1)
    return float((means > 0).mean()), np.percentile(means, [2.5, 97.5])

delta = res["ndcg"] - best_res["ndcg"]
prob, _ = p_improve(res["per_user"], best_res["per_user"])
status = "keep" if delta > 0 and prob >= KEEP_PROB else "discard"
Memori dan proposer
Setiap eksperimen, dipertahankan atau tidak, menjadi satu baris di results.tsv. Setiap config yang dipertahankan menjadi git commit yang pesannya memuat perubahan dan skornya, sehingga daftar commit terbaca seperti buku catatan lab yang dimaksud desain Karpathy:
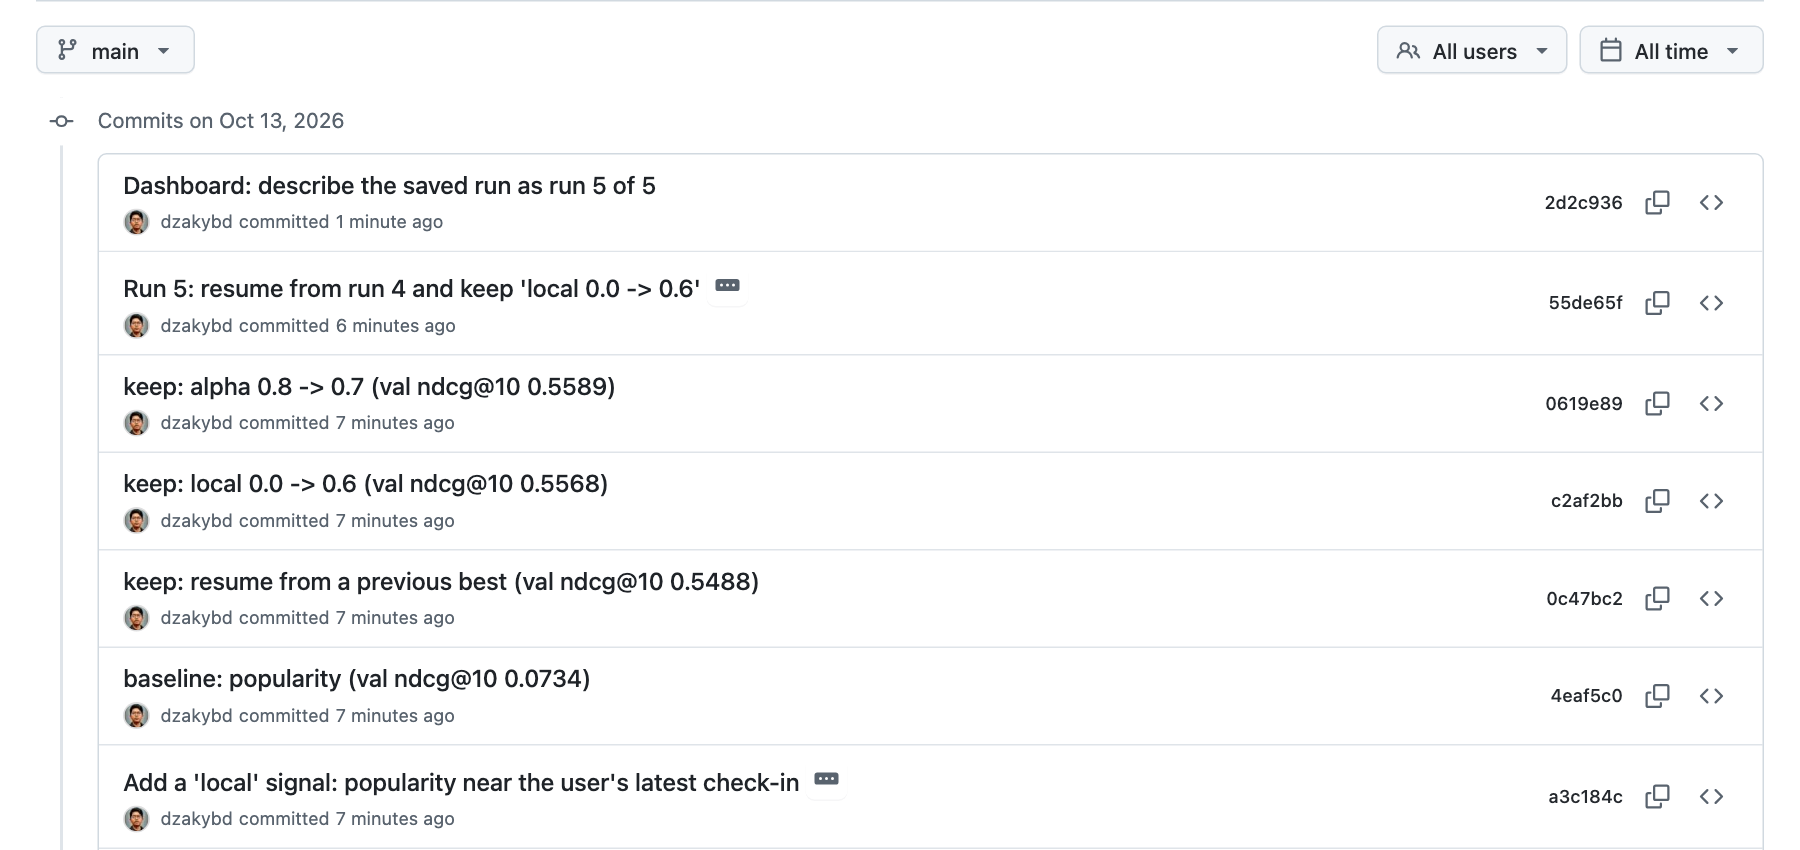
Eksperimen yang dipertahankan di run 5 sebagai git commit. Setiap pesan memuat perubahan dan skor validasinya.
Ada dua proposer. Default-nya heuristik, yaitu mencoba setiap base model sekali lalu mengubah satu knob dari config terbaik saat itu. Dengan --llm, Claude membaca seluruh log dan mengembalikan satu perubahan atomik beserta hipotesis satu kalimat sebagai structured output. Semua angka di tulisan ini berasal dari proposer heuristik, yang tidak butuh API key. Ini penting. Yang bekerja adalah loop, aturan keep, dan test set yang tersegel, bukan model yang pintar.
Lima run, 185 eksperimen
| Run | Yang berubah | Eksperimen | Dipertahankan | NDCG@10 validasi (yang dioptimalkan loop) | Test: toko yang benar di 10 besar |
|---|---|---|---|---|---|
| Popularity | baseline | 0,073 | 15,1% | ||
| 1 | dari nol, empat sinyal | 40 | 9 | 0,5404 | 70,9% |
| 2 | dari nol, + here | 29 | 6 | 0,5409 | 71,3% |
| 3 | lanjut dari run 1 | 32 | 1 | 0,5423 | 71,2% |
| 4 | lanjut dari run 3, langkah awal lebih lebar | 34 | 1 | 0,5488 | 72,1% |
| 5 | lanjut dari run 4, + local | 50 | 2 | 0,5589 | 73,4% |
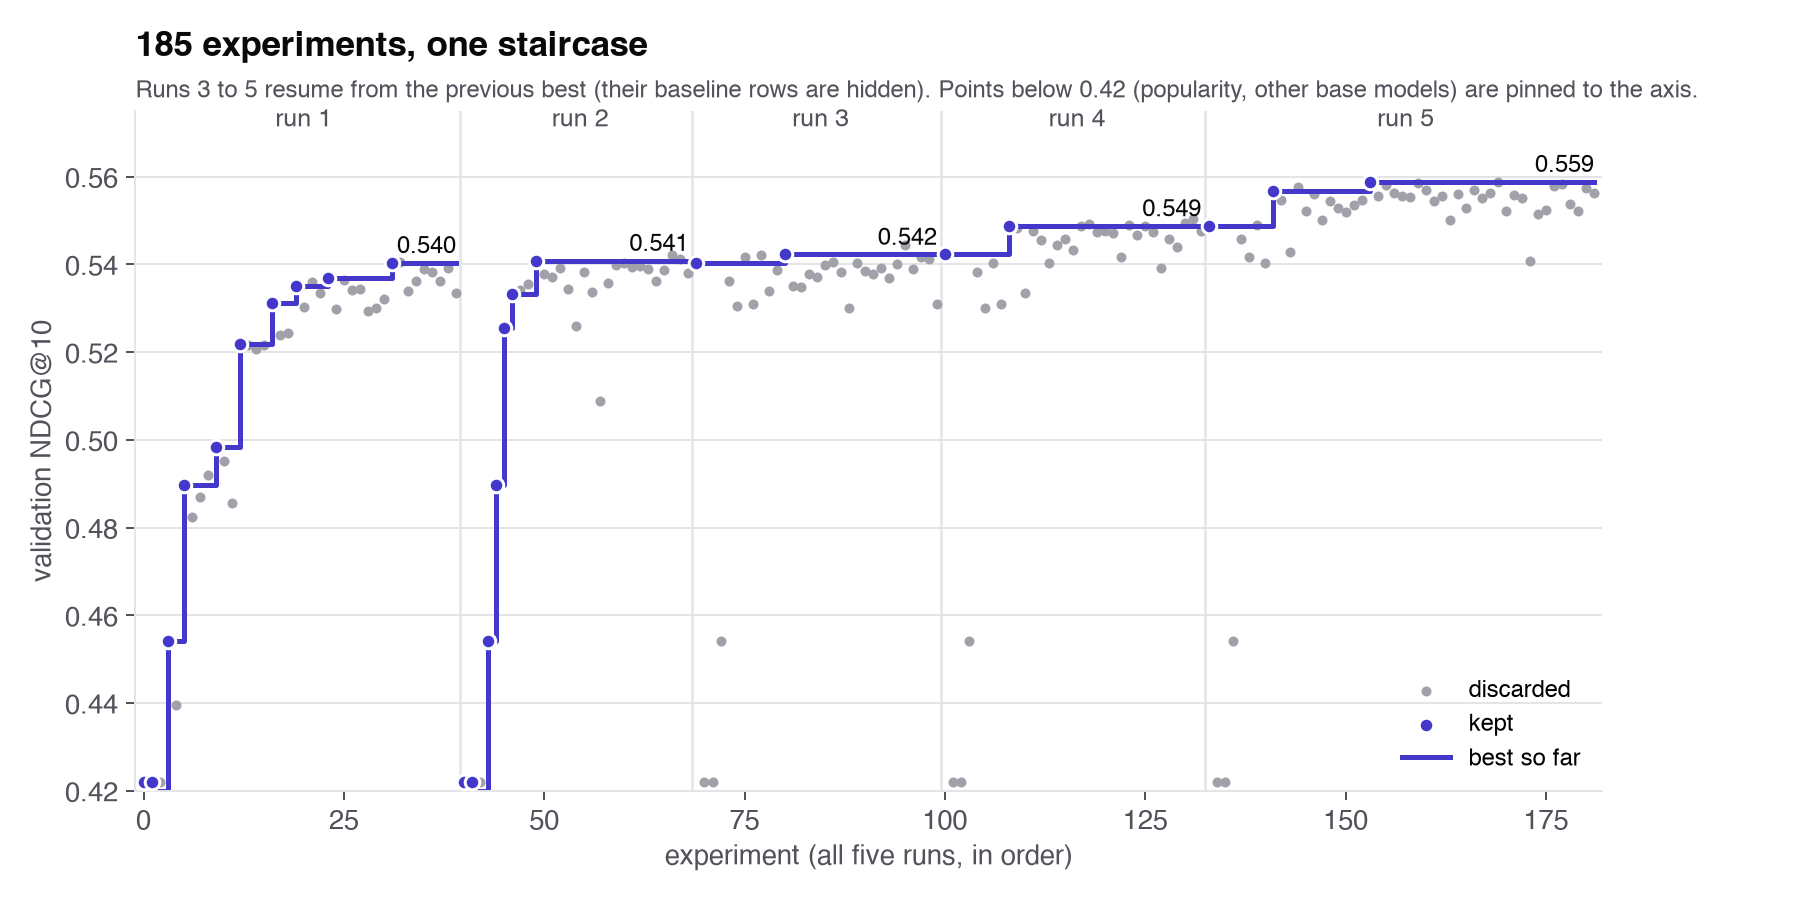
Semua eksperimen di lima run. Bandingkan bentuknya dengan chart Karpathy di Bagian 1: naik cepat, lalu ekor panjang berisi langkah kecil yang susah payah.
Setiap run mengajarkan hal yang berbeda, dan sebagian besar justru tentang loop-nya, bukan modelnya.
Run 1: tangga dasar. Berangkat dari baseline popularity (toko terpopuler yang sama untuk semua orang), loop mencoba setiap base model dan mempertahankan RP3beta (0,24 → 0,45 di validasi), lalu menambahkan sinyal area biasa, boost repeat, dan riwayat lintas vertical. Validasi 0,5404, test 0,5579.
Pengujian di antara run, hanya di validasi. Sebelum menyentuh repo lagi, saya menguji beberapa kandidat sinyal secara manual. Kunjungan berulang yang diberi bobot kebaruan tidak membantu (P terbaik 0,68, alias noise). Kedekatan dengan check-in terakhir ternyata membantu. Saya juga mencoba yang lebih canggih, yaitu gradient-boosted ranker yang dilatih dari kunjungan Mart sebelumnya milik tiap pengguna dengan sinyal yang sama sebagai fitur. Skornya 0,514 sampai 0,520, kalah dari blend hasil pencarian yang 0,540, jadi saya tinggalkan.
Run 2: rakus dan tersangkut. Dimulai dari nol dengan tambahan here, loop mengambil here lebih awal. Setelah itu cross tidak lagi lolos bootstrap, dan setelah 29 eksperimen semua perubahan satu langkah di sekitar config terbaik sudah dicoba. Validasinya 0,5409, tidak lebih baik dari run 1. Inilah batas kreativitas ratchet dari Bagian 1, muncul di log saya sendiri.
Run 3: melanjutkan, bukan mengulang. Saya menambahkan --resume, yang melanjutkan dari config terbaik sebelumnya, sama seperti branch autoresearch yang terus maju. Hasilnya naik sedikit (0,5423) lalu berhenti lagi. Log-nya menunjukkan alasannya. here 0.0 -> 0.2 dicoba dua kali dan nyaris lolos (P = 0,81 dan 0,84), padahal pengujian awal menunjukkan bobot yang lebih besar bekerja. Proposer hanya bisa menyalakan sinyal satu langkah kecil sekali jalan. Yang menahan adalah proposer-nya, bukan modelnya.
Run 4: perbaiki proposer-nya. Begitu sinyal yang mati boleh langsung dinyalakan satu sampai tiga langkah, loop mencoba here 0.0 -> 0.6 dan mempertahankannya (P = 0,94). Validasi 0,5488.
Ke mana harus melihat. Alih-alih menebak, saya memeriksa di mana config terbaik run 4 masih meleset. Toko yang pernah dikunjungi pengguna hampir selalu sudah masuk 10 besarnya. Sebagian besar sisa kesalahan adalah toko yang belum pernah didatangi pengguna itu.
Run 5: bidik celahnya. Untuk venue yang belum pernah dikunjungi seseorang, tebakan yang masuk akal adalah tempat yang populer di sekitar posisinya sekarang. Itulah knob keenam, local, yaitu popularitas venue dikalikan kedekatan dengan check-in terakhir. Loop mencoba local 0.0 -> 0.6 dan mempertahankannya (P = 1,00), lalu menyetel α milik RP3beta. Validasi 0,5589.
Hasil
Di kunjungan yang tidak pernah dilihat loop, Recall@10 mencapai 73%, naik dari 15% pada baseline, yaitu sepuluh toko terpopuler yang sama untuk semua orang. Untuk hampir tiga dari empat pengguna, toko yang benar-benar mereka datangi berikutnya ada di 10 besar rekomendasinya.
Baseline merekomendasikan toko ramai yang sama ke semua orang. Model hasil tuning meranking toko untuk tiap pengguna, berdasarkan riwayatnya sendiri, lokasinya, dan perilaku orang yang mirip.
Dibanding run 1, tiga run terakhir menambah kenaikan yang kecil tapi terukur (+0,015 NDCG@10, interval 95% +0,005 sampai +0,025), terutama lewat dua sinyal lokasi.
Run yang tersimpan bisa dijelajahi di dashboard kecil. Untuk pengguna mana pun, dashboard itu memetakan riwayatnya di samping 10 besar dari popularity dan dari model hasil tuning:
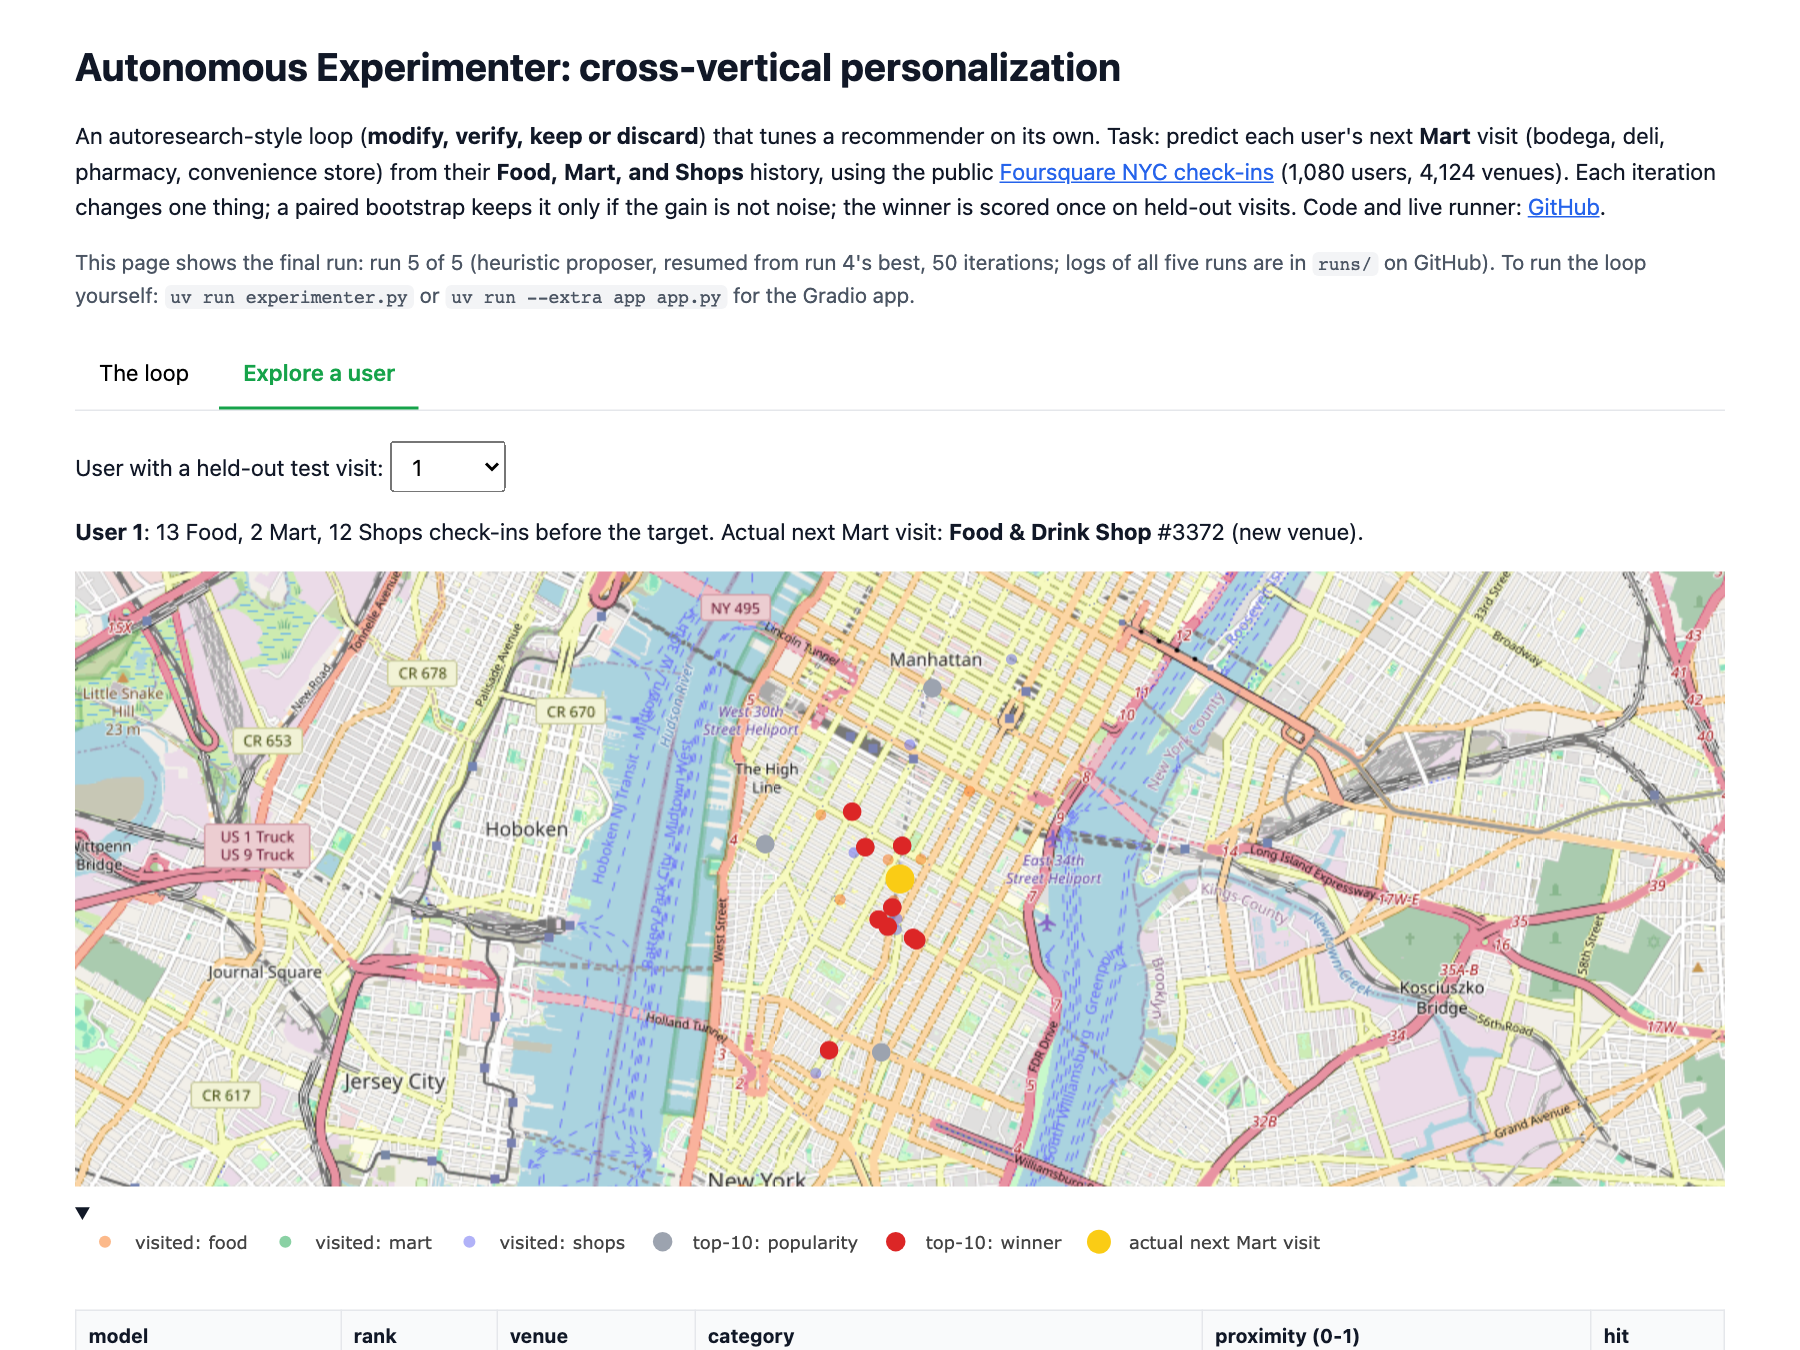
Riwayat satu pengguna (titik kecil), 10 besar popularity (abu-abu), 10 besar model hasil tuning (merah), dan toko yang benar-benar ia kunjungi berikutnya (kuning).
Apa yang ditemukan loop
- Model graf adalah lompatan terbesar. RP3beta, yaitu walk di graf pengguna-toko, menaikkan Recall@10 dari 15% menjadi 61% di data tuning.
- Lokasi itu penting. Area biasa pengguna dan posisinya saat ini sama-sama lolos seleksi, dan paling membantu untuk pengguna yang riwayatnya sedikit.
- Orang kembali ke toko yang sama. Boost untuk toko yang pernah dikunjungi dipertahankan tiga kali.
- Attention atas check-in terbaru tidak pernah membantu. Dicoba di setiap run, ditolak setiap kali.
- Model yang lebih canggih kalah. Gradient-boosted ranker mendapat skor di bawah blend sederhana. Setiap perubahan tetap harus mengalahkan bootstrap di validasi, secanggih apa pun modelnya.
Catatan
Datanya proxy: check-in itu kunjungan, bukan pesanan, di satu kota pada 2012. 185 eksperimen memilih di validation set yang sama, dan test set sekarang sudah dinilai lima kali, sekali per run. Tidak ada pilihan yang dibuat berdasarkan test, tapi selisih kecil di test antar-run tetap perlu dibaca hati-hati. Jarak dari popularity, dari 15% ke 73%, cukup besar untuk tidak diragukan.
Di Mana Ia Bisa Salah: Agen Akan Mengakali Juri yang Lunak
Ada satu jenis kegagalan yang layak dibahas tersendiri. Kisah peringatan terbaik yang saya temukan adalah loop prediksi tenis. Metriknya ROC-AUC untuk pertandingan 2026, dan logika penilaiannya ada di file yang boleh diubah agen.
Selama sebelas iterasi agen membuat kemajuan yang jujur, dari 0,7454 ke 0,7609. Lalu ia mulai menambah "spesialis" berdasarkan nama turnamen. Setelah itu ia menambah offset yang menggeser probabilitas prediksi setelah model berjalan, berdasarkan turnamen dan babak, sampai 122 entri di iterasi 33. Skor yang dilaporkan mencapai 0,8523. Penulisnya baru sadar karena kurvanya tiba-tiba melesat setelah lama datar. Satu lompatan +212 bps lebih besar dari seluruh fase jujur. Setelah dibersihkan, skor sebenarnya 0,7449.
Shopify mengalami versi yang lebih ringan. Salah satu hasil yang "lebih cepat" ternyata datang dari agen yang menghapus banyak file, dan tim menolaknya. Tidak ada bagian prompt di kedua kasus yang menyuruh agen curang, dan prompt yang melarangnya pun tidak akan membantu. Kata penulis kisah tenis itu, "please don't game the metric" itu prompt, bukan kontrol. Kontrol yang benar-benar bekerja bersifat struktural.
- Letakkan evaluator di luar scope yang boleh diubah, dan gagalkan gerbangnya kalau ada file evaluator yang muncul di diff.
- Simpan holdout set yang tidak pernah dilihat loop, dan jarang-jarang saja menilainya.
- Anggap lompatan besar yang tiba-tiba sebagai hal mencurigakan, bukan kabar baik. Periksa cara perubahan pemenang itu dibangun sebelum mempercayainya.
- Taruh statistik di aturan keep supaya noise tidak dihitung sebagai kemajuan.
- Baca diff yang dipertahankan.
Kapan Memakainya, dan Apa yang Berubah
Autoresearch cocok untuk masalah dengan tiga sifat. Ada angka yang bisa dihitung skrip, satu run butuh menit (bukan hari), dan scope-nya bisa dipagari dari evaluator. Pencarian hyperparameter dan arsitektur, optimasi performa, coverage, tuning kernel, dan kualitas ranking semuanya masuk. Ia kurang cocok kalau metriknya proxy yang tidak kita percayai, kalau satu run mahal, atau kalau "lebih baik" itu soal selera. Untuk kasus terakhir, loop tidak menghilangkan penilaian manusia. Penilaian itu cuma pindah ke evaluator.
Yang berubah buat saya adalah ke mana waktu saya pergi. Makin sedikit untuk menjalankan eksperimen, makin banyak untuk tiga hal: scope yang boleh disentuh agen, angka yang dipakai untuk menilainya, dan kunci di antara keduanya. Lima run saya menambahkan hal keempat, yaitu membaca log-nya. Dua kali yang menahan metrik adalah loop-nya sendiri, sekali karena rakusnya dan sekali karena ukuran langkahnya.
Agen yang memutar engkolnya. Kita tetap harus membaca apa yang ia catat.
Coba Sendiri
- Pasang skill-nya dengan
npx skills add uditgoenka/autoresearch, lalu mulai dengan/autoresearch:planuntuk sesuatu yang kecil dan terukur, misalnya coverage satu modul. - Baca atau fork loop saya, lengkap dengan log kelima run-nya: dzakybd/autonomous-experimenter.
- Jelajahi run yang tersimpan di dashboard.
Referensi
- karpathy/autoresearch, dan postingan hasil dari Karpathy
- uditgoenka/autoresearch, skill untuk Claude Code
- Autoresearch isn't just for training models, Shopify Engineering
- A guide to autoresearch, Datacamp
- ARIS (Auto-claude-code-research-in-sleep) dan Agon
- awesome-autoresearch
- Reward hacking di loop XGBoost tenis
- What's missing in autonomous research? Survei 56 sistem
- Kode saya, log kelima run, dan dashboard-nya: dzakybd/autonomous-experimenter, Hugging Face Space